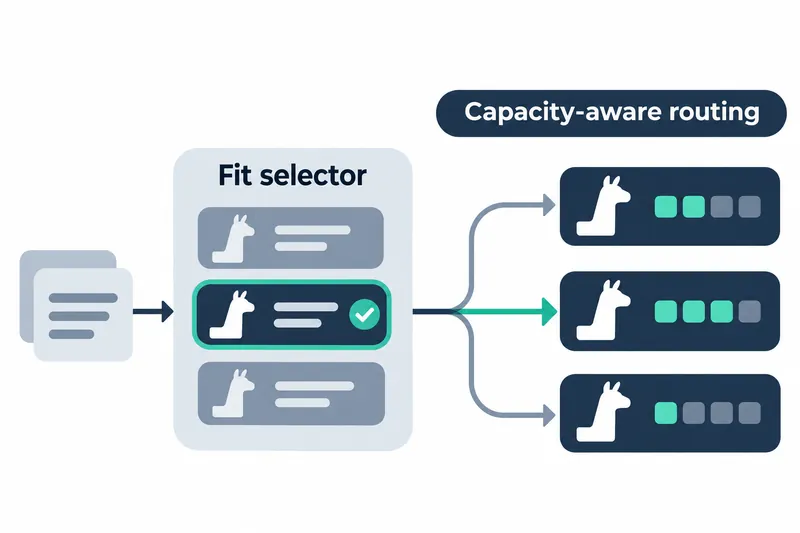
在一台服务器上运行多种大小的人工智能模型时,开发者现在可以根据剩余资源自动选择请求目标。llama-swap 的新版本会从预先分组的候选项中,选择当前运行负担较小的模型来接收请求。这项变化适合希望用小模型替代大模型,或使用上下文较短的变体的环境;上下文指模型一次可处理的输入范围。
1. 优先选择当前运行负担较小的候选项,而非大模型
v273 新增的 fit 是从多个候选项中选择请求接收模型的选择器。它向在资源限额内管理模型运行与切换的容量路由器,查询各候选项的切换计划。也就是说,先考虑为了腾出空间需要移除哪些模型。
选择依据是待卸载模型的 evict_cost 总和。这是为从内存中卸载模型设定的成本值,总和较低的候选项优先。如果总和相同,则优先选择卸载模型数量较少的候选项,再按已就绪、启动中、未运行的顺序选择;若仍相同,则遵循候选列表顺序。
如果已就绪的小模型和需要新启动的大模型都能在不卸载其他模型的情况下运行,小模型将优先。因此,即使把大模型放在列表首位,也不意味着优先运行它。选择时会先考虑当前运行状态和卸载其他模型的负担,而非模型大小。
2. 配置容量路由器和候选列表
这一策略必须与 capacity 路由器搭配使用。候选项仅限本地模型,在 capacities 中配置各模型的资源用量后,路由器便会判断能否运行及卸载计划。发布说明链接的文档提供了如下配置示例。
selectors:
  any-llama:
    strategy: fit
    targets: [llama-70b, llama-8b-q8, llama-8b-q4]   # order = preference
    settings:
      no_evict: false   # true: 429 instead of choosing a target that unloads a model
    name: "Any Llama"
示例中的候选列表将多个模型归入同一个请求名称。列表顺序仅在前面的选择条件全部相同时使用,因此运维人员需在设定偏好顺序的同时,配置各候选项的实际资源用量。即使请求使用同一个名称,每次也会重新检查资源状态,确定实际处理请求的模型。
evict_cost 的默认值为 0。如果不单独设置成本,选择就取决于卸载模型数量、就绪状态和列表顺序。如果更重视让某个模型留在内存中,可以在配置中体现卸载该模型的成本。
3. 也可以只选择无需卸载模型的候选项
启用 no_evict 后,会跳过需要卸载运行中模型的候选项。如果没有任何候选项能在不卸载模型的情况下运行,选择器会以 HTTP 429 拒绝请求,此时请求不会传给路由器。即使模型的卸载成本为 0,只要实际需要卸载,也会被排除,因此是否卸载模型的判断独立于成本值。
需要注意的是,如果省略候选项的 capacities,它就会被视为不使用资源,因而始终被判定为可运行。此外,no_evict 只在选择候选项的瞬间生效,所以如果检查后其他请求启动了模型切换,路由器仍可能卸载模型。
4. 工作重心从逐次选择请求目标转向候选项管理
好处在于,资源余量变化时,开发者不必每次手动修改请求目标,而是可以在同一个名称下组织并使用备选模型。如果运行环境允许用更小的变体或更短的上下文处理请求,就可以将其纳入选项。
代价是运维人员需要管理各变体的资源用量,并用成本值表达哪些模型应留在内存中。选择不卸载模型的设置后,保留现有模型可能意味着拒绝新请求。是否采用这一功能,关键在于如何权衡使用备选模型的灵活性与保留当前运行模型的需要。
v273 的变化在于扩展了选择标准:不再优先选择最大的模型,而是根据当前资源和模型切换负担分配请求。