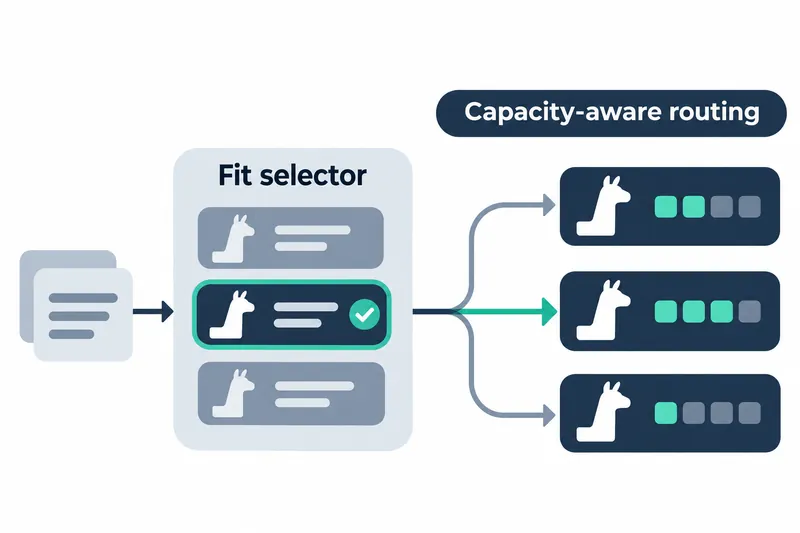
複数のサイズのAIモデルを1台のサーバーで動かす開発者が、残りのリソースに合わせてリクエスト先を自動で選べるようになった。llama-swapの新バージョンは、あらかじめまとめた候補の中から、現時点で実行負担の小さいモデルへリクエストを送る。大きなモデルの代わりに小さなモデルや、一度に扱える入力範囲であるコンテキストが短いバリエーションを活用したい環境に向けた変更だ。
1. 大きなモデルより今の実行負担が小さい候補を優先する
v273で追加されたfitは、複数の候補からリクエストを受けるモデルを選ぶセレクターだ。リソース上限内でモデルの実行と入れ替えを管理する容量ルーターに、候補ごとの入れ替え計画を問い合わせる。空きを作るために何を取り除く必要があるかを先に検討する方式だ。
選択基準は、アンロードするモデルに設定されたevict_costの合計だ。これはモデルをメモリから降ろすことに割り当てたコスト値で、合計が低い候補を優先する。同じならアンロードするモデル数が少ない方、次に準備完了・起動中・未実行の順に選び、ここまで同じなら候補リストの順序に従う。
準備済みの小さなモデルと新たに起動する必要のある大きなモデルが、どちらも他のモデルをアンロードせずに実行できるなら、小さなモデルが優先される。そのため、リストの先頭に大きなモデルを書いても、それを優先実行する方式ではない。モデルのサイズより現在の実行状態と他のモデルをアンロードする負担を先に反映する。
2. 容量ルーターと候補リストを設定する
この戦略はcapacityルーターと併用する必要がある。候補はローカルモデルに限られ、各モデルのリソース使用量をcapacitiesに設定すると、ルーターが実行可否とアンロード計画を判断する。設定例は、リリースからリンクされたドキュメントに次のように示された。
selectors:
  any-llama:
    strategy: fit
    targets: [llama-70b, llama-8b-q8, llama-8b-q4]   # order = preference
    settings:
      no_evict: false   # true: 429 instead of choosing a target that unloads a model
    name: "Any Llama"
この例では、候補リストで複数のモデルを1つのリクエスト名にまとめる。リストの順序は先の選択基準がすべて同じ場合に使うため、運用者は優先順と併せて各候補の実際のリソース使用量を設定する。同じ名前でリクエストしても、その都度リソース状態を確認し直して実際に処理するモデルを決める。
evict_costのデフォルト値は0だ。個別にコストを設定しなければ、アンロードするモデル数、準備状態、リストの順序が選択を分ける。特定のモデルをメモリに残すことをより重視するなら、そのモデルをアンロードするときのコストを設定に反映できる。
3. モデルをアンロードしない選択もできる
no_evictを有効にすると、実行中のモデルのアンロードを伴う候補をスキップする。アンロードせずに実行できる候補が1つもなければ、セレクターはHTTP 429でリクエストを拒否し、ルーターには渡さない。アンロードコストが0のモデルも実際にアンロードするなら除外対象となるため、コスト値とは別にアンロードの有無を判断する。
注意点は、候補のcapacitiesを省略するとリソースを使用しないものとして扱われ、常に実行可能な候補になることだ。また、no_evictは候補を選ぶ瞬間に適用されるため、確認後に別のリクエストがモデルの入れ替えを始めると、ルーターがモデルをアンロードする可能性がある。
4. リクエストごとの選択の手間が候補の管理へ移る
利点は、リソースの空きが変わるたびに開発者がリクエスト先を手動で変える代わりに、1つの名前の背後に代替候補をまとめて活用できることだ。より小さなバリエーションや短いコンテキストでもリクエストを処理できる環境なら、それらを選択肢に加えられる。
その代わり、運用者はバリエーションごとにリソース使用量を管理し、どのモデルをメモリに残すかをコスト値で表す必要がある。モデルをアンロードしない設定を選ぶと、既存モデルを維持する代わりに新たなリクエストが拒否される場合がある。導入判断の要点は、代替モデルを活用する柔軟性と、現在実行中のモデルを維持する必要性との間に基準を設けることにある。
v273の変更は、最大のモデルを先に選ぶのではなく、現在のリソースとモデルの入れ替え負担に合わせてリクエストを振り分けるよう、選択基準を広げた点にある。