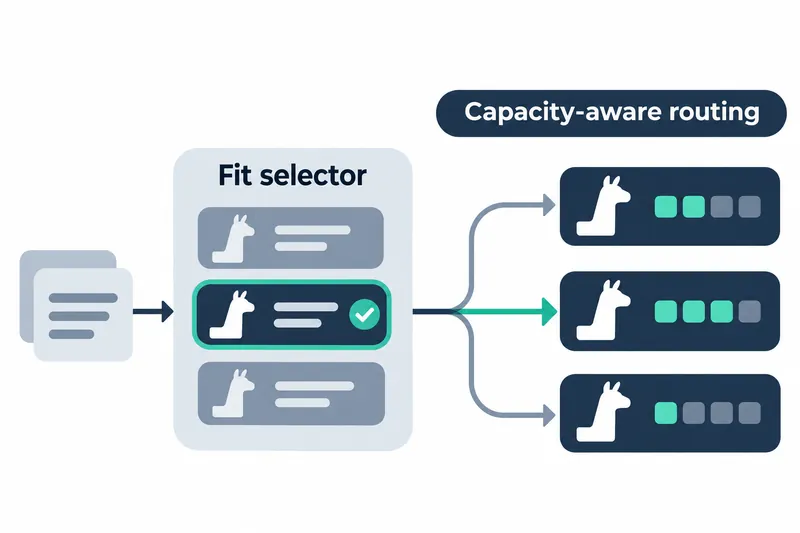
여러 크기의 인공지능 모델을 한 서버에서 돌리는 개발자가 남은 자원에 맞춰 요청 대상을 자동으로 고를 수 있게 됐다. llama-swap의 새 버전은 미리 묶어 둔 후보 가운데 지금 실행하기에 부담이 적은 모델로 요청을 보낸다. 큰 모델 대신 작은 모델이나 한 번에 다룰 입력 범위인 컨텍스트가 짧은 변형을 활용하려는 환경에 맞춘 변화다.
1. 큰 모델보다 지금 실행 부담이 작은 후보를 앞세운다
v273에 추가된 fit은 여러 후보 중 요청을 받을 모델을 고르는 셀렉터다. 자원 한도 안에서 모델 실행과 교체를 관리하는 용량 라우터에 후보별 교체 계획을 물어본다. 빈자리를 만들기 위해 무엇을 치워야 하는지 먼저 따지는 방식이다.
선택 기준은 내릴 모델에 설정된 evict_cost의 합계다. 이는 모델을 메모리에서 내리는 데 부여한 비용값으로, 합계가 낮은 후보가 먼저다. 같으면 내리는 모델 수가 적은 쪽, 그다음 준비 완료·시작 중·미실행 순으로 고르고, 여기까지 같으면 후보 목록의 순서를 따른다.
이미 준비된 작은 모델과 새로 시작해야 하는 큰 모델이 모두 다른 모델을 내리지 않고 실행될 수 있다면 작은 모델이 앞선다. 따라서 목록 맨 앞에 큰 모델을 적더라도 그 모델을 우선 실행하는 방식은 아니다. 모델 크기보다 현재 실행 상태와 다른 모델을 내리는 부담을 먼저 반영한다.
2. 용량 라우터와 후보 목록을 설정한다
이 전략은 capacity 라우터와 함께 사용해야 한다. 후보는 로컬 모델로 한정되며, 각 모델의 자원 사용량을 capacities에 설정하면 라우터가 실행 가능 여부와 해제 계획을 판단한다. 설정 예시는 릴리스에 연결된 문서에 다음과 같이 제시됐다.
selectors:
  any-llama:
    strategy: fit
    targets: [llama-70b, llama-8b-q8, llama-8b-q4]   # order = preference
    settings:
      no_evict: false   # true: 429 instead of choosing a target that unloads a model
    name: "Any Llama"
예시에서 후보 목록은 여러 모델을 하나의 요청 이름으로 묶는다. 목록 순서는 앞선 선택 기준이 모두 같을 때 쓰이므로, 운영자는 선호 순서와 함께 각 후보의 실제 자원 사용량을 설정한다. 같은 이름으로 요청해도 매번 자원 상태를 다시 살펴 실제 처리 모델을 정한다.
evict_cost의 기본값은 0이다. 별도로 비용을 설정하지 않으면 내리는 모델 수, 준비 상태, 목록 순서가 선택을 가른다. 특정 모델을 메모리에 남기는 일을 더 중요하게 다루려면 그 모델을 내릴 때의 비용을 설정에 반영할 수 있다.
3. 모델을 내리지 않는 선택도 가능하다
no_evict를 켜면 실행 중인 모델을 내리는 후보를 건너뛴다. 내리지 않고 실행할 수 있는 후보가 하나도 없으면 셀렉터는 HTTP 429로 요청을 거절하며, 이때 요청은 라우터에 전달되지 않는다. 해제 비용이 0인 모델도 실제로 내리게 된다면 제외 대상이므로 비용값과 별도로 모델 해제 여부를 판단한다.
주의할 점은 후보의 capacities를 생략하면 자원을 사용하지 않는 것으로 처리돼 항상 실행 가능한 후보가 된다는 점이다. 또 no_evict는 후보를 고르는 순간에 적용되므로, 확인 뒤 다른 요청이 모델 교체를 시작하면 라우터가 모델을 내릴 수 있다.
4. 요청마다 고르는 수고가 후보 관리로 옮겨간다
이점은 자원 여유가 바뀔 때마다 개발자가 요청 대상을 직접 바꾸는 대신, 하나의 이름 뒤에 대체 후보를 묶어 활용할 수 있다는 점이다. 더 작은 변형이나 더 짧은 컨텍스트로도 요청을 처리할 수 있는 환경이라면 이를 선택지에 넣을 수 있다.
그 대가로 운영자는 변형마다 자원 사용량을 관리하고, 어떤 모델을 메모리에 남길지 비용값으로 표현해야 한다. 모델을 내리지 않는 설정을 택하면 기존 모델을 유지하는 대신 새 요청이 거절될 수 있다. 도입 판단의 핵심은 대체 모델을 활용할 유연성과 현재 실행 중인 모델을 유지할 필요 사이에 기준을 세우는 데 있다.
v273의 변화는 가장 큰 모델을 먼저 고르는 대신, 현재 자원과 모델 교체 부담에 맞춰 요청을 나누도록 선택 기준을 넓힌 데 있다.