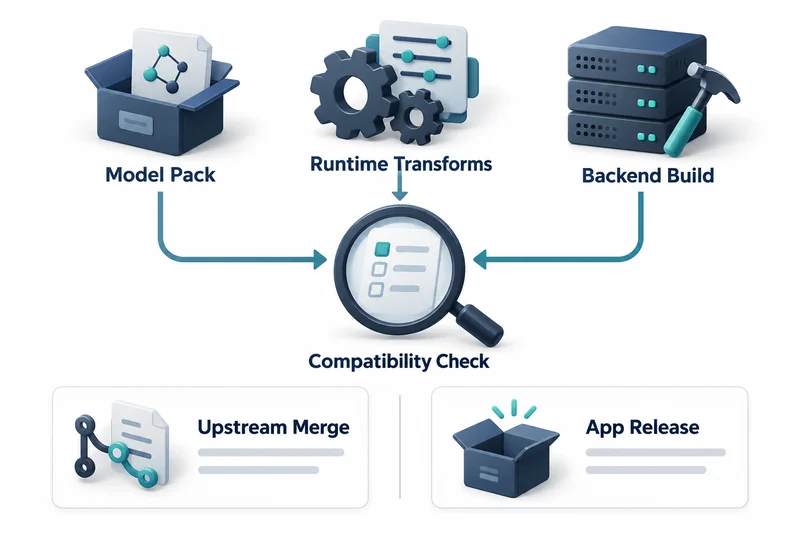
llama.cpp 于 10 月 11 日合并了 PR 29600“Runtime support for Prism Bonsai 2 27B”。针对该模型的运行时工作进入了上游。
PR 作者在 9 月 29 日用同一个 Q2_0 文件与 Prism 分支比较了正确性。Metal(M5)上的 PPL 比为 1.0001,CUDA(A100)上为 0.9995;没有该 PR 的 master 在同一模型上的 PPL 约为 126 万。
这是限于特定文件和后端的贡献者侧证据,并非覆盖所有打包格式和后端的验证,也不是独立复现。
仅有权重格式为何不够
根据模型卡,Bonsai 2 把分块 Hadamard 旋转折叠进存储的权重中。因此推理时必须对激活值施加相应的变换。
PTQ1_0 和 PQ2_0 文件使用各自的打包格式。GGUF 扩展名只是容器,并不保证运行时实现了其中所需的全部功能。
注意事项:合并与文档之间的不一致
10 月 13 日核对的 Prism 模型卡仍指向其自有分支。它说明原版 llama.cpp 会把 PQ2_0 和 PTQ1_0 当作未知类型拒绝,而对 Q2_0 会无警告地加载并输出乱码。
后端文档也写明上游集成仍在等待中,并要求所有 Bonsai 2 GGUF 格式都使用该分支。新的上游构建与各个已发布包的组合完成到什么程度,尚未得到确认。
PTQ1_0 格式另由 PR 29672 推进。一次合并并不等于全面的兼容性公告。
后端文档中分开的两张支持表
后端文档把文件格式表与 Hadamard 变换表分开列出。文档明确指出还需要符号翻转和模型图变换,仅有格式解码或单独的变换内核并不够。
这些表反映的是特定分支版本的源码实现状态。例如在 SYCL 路径上,PTQ1_0 会展开成 PQ2_0 大小的布局,所以文件更小并不保证 GPU 内存更小。
把运行组合作为一个整体记录
把模型文件名和版本、运行时提交或软件包版本、所选设备和后端以及实际启动参数记录为一个组合。速度结果也附上这个组合。
这样即使应用更换了内置运行时,或模型仓库更改了推荐打包格式,成功过的测试仍可复现。
以输出而非加载为准的首次检查
失败可能表现为错误文本而不是报错,所以仅靠文件加载或输出 token 的验证很弱。先用已知答案的短提示,再扩展到有代表性的任务,更为可靠。
模型卡说明默认推理强度为 xhigh,不支持 low,选择 low 时行为接近 xhigh。输出预算太小导致思考过程被截断,很容易被误认为后端故障。
合并之后仍需确认的事项
这次合并为下游应用提供了可以采纳的具体变更。在应用记录相关运行时与格式支持之前,遵循项目的版本锁定说明,并先确认正确性再看速度。
本文没有运行任何硬件或模型。
上游合并只是起点,哪个文件能在哪个构建和后端上正确运行,仍要逐个组合确认。