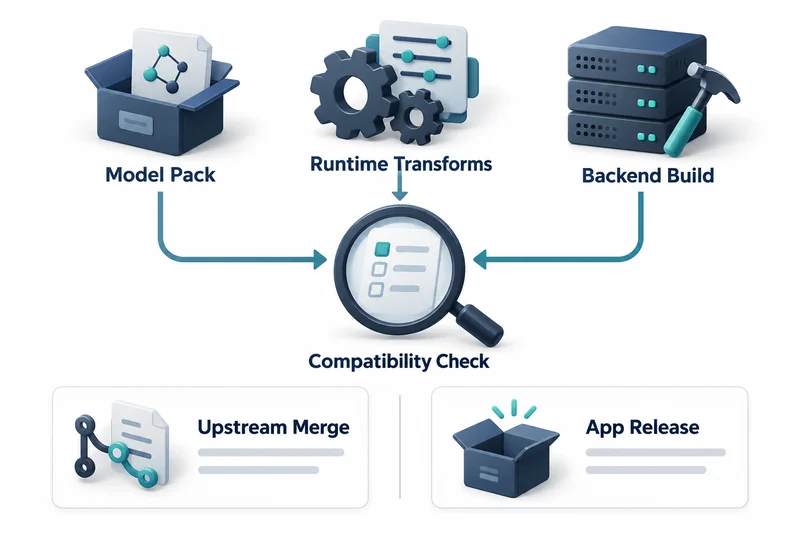
llama.cppは10月11日にPR 29600「Runtime support for Prism Bonsai 2 27B」をマージした。モデル固有のランタイム作業が上流に入ったことになる。
PR作成者は9月29日、同じQ2_0ファイルでPrismフォークと正確性を比較した。Metal(M5)でPPL比1.0001、CUDA(A100)で0.9995で、このPRがないmasterは同じモデルでPPL約126万だった。
これは特定のファイルとバックエンドに限られた貢献者側の証拠だ。すべてのパッキング・バックエンドの検証や独立した再現ではない。
重みの形式だけでは足りない理由
モデルカードによると、Bonsai 2はブロック単位のHadamard回転を保存された重みに畳み込んでいる。そのため推論時に活性値へ対応する変換を適用する必要がある。
PTQ1_0とPQ2_0のファイルは別々のパッキング形式を使う。GGUFの拡張子はコンテナにすぎず、ランタイムが中身の機能をすべて実装している保証ではない。
注意点:マージと文書の食い違い
10月13日に確認したPrismのモデルカードは今も自社フォークを案内している。標準のllama.cppはPQ2_0とPTQ1_0を未知の形式として拒否し、Q2_0は警告なしに読み込んで意味のない出力を出すと説明している。
バックエンド文書も上流への統合を保留中とし、すべてのBonsai 2 GGUFにフォークを使うよう求めている。新しい上流ビルドと公開済みの各パックの組み合わせがどこまで完成しているかは確認されていない。
PTQ1_0形式は別のPR 29672に引き継がれた。1つのマージは包括的な互換性の発表ではない。
バックエンド文書が分ける2つの対応表
バックエンド文書はファイル形式の表とHadamard変換の表を分けている。符号反転とモデルグラフの変換も必要で、形式のデコードや変換カーネル単体では足りないと明記している。
この表は特定のフォークリリース時点のソース実装の状態だ。例えばSYCL経路ではPTQ1_0がPQ2_0サイズの配置に展開されるため、ファイルが小さくてもGPUメモリが小さい保証はない。
実行の組み合わせを1つの単位で記録する方法
モデルのファイル名とリビジョン、ランタイムのコミットまたはパッケージのバージョン、選んだデバイス・バックエンド、実際の起動引数を1つの組み合わせとして記録する。速度の結果にもその組み合わせを付ける。
そうすれば、アプリが内蔵ランタイムを変えたりモデルリポジトリが推奨パッキングを変えたりした後も、成功したテストを再現できる。
ロードではなく出力で行う最初の確認
失敗はエラーではなく誤ったテキストとして現れうるため、ファイルのロードやトークン出力だけでは検証として弱い。答えが分かっている短いプロンプトから始めて代表的なタスクへ広げる方が確実だ。
モデルカードは、既定の推論強度がxhighで、lowは非対応のためxhighに近い動作になると説明している。出力予算が小さく思考過程が途中で切れたのを、バックエンドの故障と取り違えやすい。
マージの後に残る確認事項
今回のマージで、下流のアプリが取り込むべき具体的な変更ができた。アプリが関連するランタイムと形式の対応を文書化するまでは、プロジェクトのバージョン固定の案内に従い、速度より先に正確性を確認する。
この記事ではハードウェアやモデルを実行していない。
上流へのマージは出発点であり、どのファイルがどのビルドとバックエンドで正しく動くかは、今も組み合わせごとに確かめることだ。