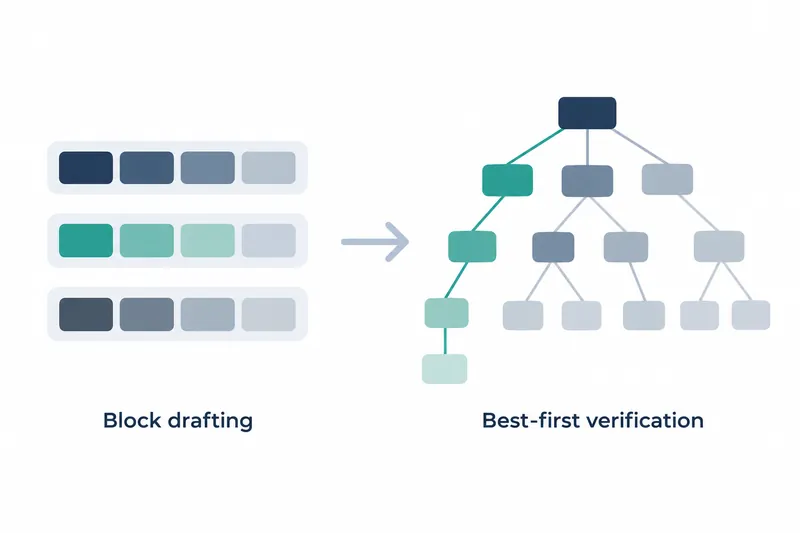
本地推理引擎 Kapitsa,即根据输入计算答案的软件,在苹果芯片上默认提供加快回答生成的 KFlash。使用 Mac 编程工具的开发者可将小模型提出的候选按树状而非单链一起检查,让大模型通过一次计算生成更多 token。
使用编程工具或本地模型的开发者,可以在同一次计算中利用更多候选。项目公布的 M4 Pro 测量显示,三个模型生成 512 token 编程回答的速度分别提高了 3.2~6.0%。
1. 连候选的下一备选项也一并检查
块草稿模型是预先生成后续 token 候选的小模型,一次预测接下来 7 个位置的候选。大模型加上刚生成的 token,验证 8 行,但传统的线性候选链会丢弃首个错误 token 之后的行。DFlash 和 DFlash2 为每个位置按可能性排列 16 个候选,因此即使首选出错,大模型需要的候选仍可能留在列表中。
KFlash 如同在岔路口也查看第二选择,根据候选及其分数,从可能性最高的分支开始构建树状结构。大模型在同样的 8 行计算中,沿着与自身生成 token 一致的最长分支前进。文档的示意图中,计入大模型直接补充的 token 后,链输出 2 个 token,树输出 4 个 token。
无需重新训练提出候选的模型。变化的核心在于,以不同方式利用已公开的草稿模型提供的候选列表和分数。
2. 根据设备成本选择验证规模
决定树大小的预算机制,会按待验证的行数评估预计生成的 token 数和 GPU 时间,选择有利于处理速度的规模。草稿模型的置信度根据候选实际被采纳的记录校准,计算成本也在各台 Mac 上测量。
项目测量中,Qwen3.6-35B-A3B 对散文平均选择 4.8 行,对代码和智能体回答选择约 6~7 行。在整个对比实验的 60 次树模式运行中,预测的每周期 token 数与实际值平均相差 2.6%。
苹果 GPU 的矩阵计算利用 8 行一组的数据。在每次计算全部参数的稠密模型中,由于共同读取权重,验证 1 行和 8 行的成本相近,因此相当于把原本就要付出的计算量用于其他候选。
3. 编程回答中测得的速度变化
据项目公布的数据,在 MacBook Pro M4 Pro 48GB 上,三个模型生成 512 token 编程回答的速度均有提升。测试环境为 macOS 27.0.1、高功率模式且接通电源,并锁定 GPU 独占使用,交替测量启用 KFlash 前后的构建版本,各测五次。
表:512 token 编程回答处理速度
条件:MacBook Pro M4 Pro 48GB、macOS 27.0.1、高功率模式且接通电源、GPU 独占锁定、512 token 编程回答、每次选择概率最高的 token、每个构建版本交替运行 5 次、项目自行测量
单位:token/秒
| 模型 | 此前构建版本 | KFlash | 变化(%) |
|---|---|---|---|
| Qwen3.5-4B | 179.3 | 188.5 | +5.1 |
| Qwen3.8-27B | 61.0 | 64.7 | +6.0 |
| Qwen3.6-35B-A3B | 176.1 | 181.7 | +3.2 |
在短回答中,单次生成更多 token 的收益超过了额外计算成本。使用整个模型的稠密模型,每周期 GPU 时间增加了 1~6%;仅选择部分专家的混合专家模型 35B,由于每行调用不同专家,增加了 6~12%。
在较长的智能体对话中,链本身已能每周期输出 2.9~6.4 个 token,因此 KFlash 的吞吐量,即单位时间处理量,变化仅约为 −5%~+3%。部分同时处理多个请求的路径会验证链,而非为每个请求验证树。
4. 默认启用与切回原有方式
KFlash 在使用块草稿模型的模型上默认启用。用户可通过以下命令启动本地服务器。
kapitsa serve # chat + OpenAI/Anthropic APIs at http://127.0.0.1:8000如需与原有方式比较,可通过环境变量 NI_KFLASH=0 重新启用链式验证。服务器日志会在请求后记录所选树大小、预计与实际生成的 token 数以及成本,便于查看其在自己 Mac 上的运行情况。
KFlash 的优势是通过候选探索提升吞吐量,提升幅度取决于回答长度、模型结构和验证成本。