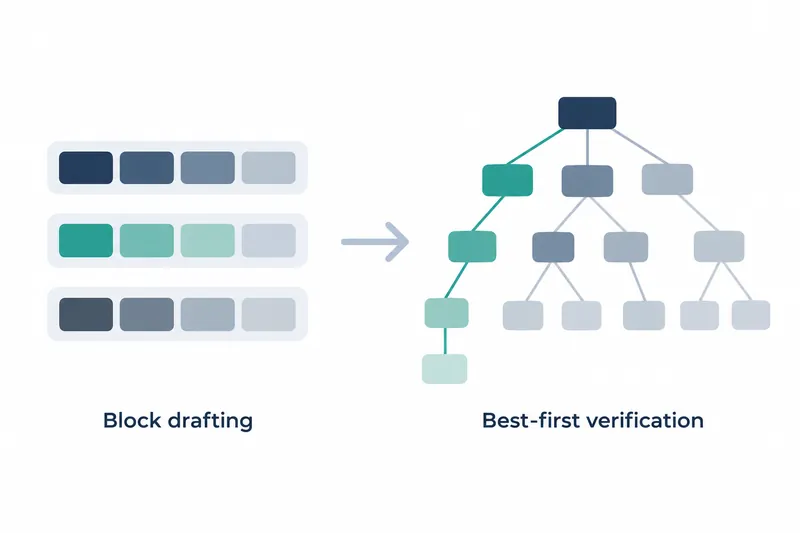
로컬 추론 엔진, 입력으로 답을 계산하는 소프트웨어인 Kapitsa가 애플 실리콘에서 답변 생성을 앞당기는 KFlash를 기본 기능으로 제공한다. 맥에서 코딩 도구를 쓰는 개발자는 작은 모델이 낸 후보를 한 줄 대신 나무 형태로 함께 검사해, 큰 모델의 한 번 계산으로 더 많은 토큰을 생성할 수 있다.
코딩 도구나 로컬 모델을 쓰는 개발자는 같은 계산 패스에서 후보를 더 활용할 수 있다. 프로젝트가 공개한 M4 Pro 측정에서는 512토큰 코딩 답변의 처리 속도가 세 모델에서 각각 3.2~6.0% 높아졌다.
1. 후보의 다음 선택지까지 확인
작은 모델인 블록 드래프터, 다음 토큰 후보를 미리 만드는 모델은 다음 7개 위치의 후보를 한꺼번에 예측한다. 큰 모델은 직전에 생성한 토큰을 더해 8개 행을 검증하지만, 기존의 일렬 후보 체인, 후보를 한 줄로 잇는 구조는 처음 틀린 토큰 뒤의 행을 버린다. DFlash와 DFlash2는 위치마다 16개 후보를 순위화해, 가능성 순서대로 배열하므로, 첫 선택이 틀려도 큰 모델이 원하는 후보가 목록에 남아 있을 수 있다.
KFlash는 갈림길에서 두 번째 선택지도 함께 살피듯, 후보와 점수로 가능성이 높은 가지부터 트리, 가지가 갈라지는 구조를 만든다. 큰 모델은 같은 8행 계산에서 자신이 생성한 토큰과 일치하는 가장 긴 가지를 따라간다. 문서의 설명용 그림에서는 큰 모델이 직접 추가하는 토큰까지 합쳐 체인이 2개, 트리가 4개 토큰을 내보낸다.
후보를 내는 모델을 다시 학습할 필요는 없다. 공개된 드래프터가 이미 제공하는 후보 목록과 점수를 다른 방식으로 활용하는 것이 변화의 핵심이다.
2. 기기별 비용에 맞춰 검증 크기 선택
트리 크기를 정하는 예산 장치, 계산량을 정하는 기준은 검증할 행 수별로 예상 생성 토큰과 GPU 시간을 따져 처리 속도에 유리한 크기를 고른다. 드래프터의 자신감은 실제 채택된 후보의 기록으로 보정하고, 계산 비용도 각 맥에서 측정한다.
프로젝트 측정에서 Qwen3.6-35B-A3B는 산문에 평균 4.8행, 코드와 에이전트 응답에 약 6~7행을 선택했다. 전체 비교 실험의 트리 실행 60회에서 예측한 사이클당 토큰 수는 실제와 평균 2.6% 차이였다.
애플 GPU의 행렬 계산은 8행 묶음을 활용한다. 밀집형 모델, 매개변수 전체를 매번 계산하는 모델에서는 가중치를 함께 읽어 1행과 8행 검증 비용이 비슷하므로, 이미 지불하던 계산량을 다른 후보에 쓰는 효과가 있다.
3. 코딩 답변에서 확인한 속도 변화
프로젝트 발표 기준, MacBook Pro M4 Pro 48GB에서 512토큰 코딩 답변 속도가 세 모델 모두 높아졌다. macOS 27.0.1, 고전력 모드와 전원 연결 상태에서 GPU를 독점하도록 잠그고, KFlash 직전 빌드와 적용 빌드를 번갈아 각각 다섯 차례 측정했다.
표: 512토큰 코딩 답변 처리 속도
조건: MacBook Pro M4 Pro 48GB, macOS 27.0.1, 고전력 모드·전원 연결, GPU 독점 잠금, 512토큰 코딩 답변, 매번 가장 확률 높은 토큰 선택, 빌드별 5회 교차 실행, 프로젝트 자체 측정
단위: 토큰/초
| 모델 | 이전 빌드 | KFlash | 변화(%) |
|---|---|---|---|
| Qwen3.5-4B | 179.3 | 188.5 | +5.1 |
| Qwen3.8-27B | 61.0 | 64.7 | +6.0 |
| Qwen3.6-35B-A3B | 176.1 | 181.7 | +3.2 |
짧은 답변에서는 한 번에 생성하는 토큰이 늘어난 이득이 추가 계산 비용을 웃돌았다. 모델 전체를 사용하는 밀집형 모델의 사이클당 GPU 시간은 1~6% 늘었고, 일부 전문가만 골라 쓰는 혼합 전문가 모델인 35B는 행마다 다른 전문가를 불러 6~12% 늘었다.
긴 에이전트 대화에서는 체인도 이미 사이클당 2.9~6.4개 토큰을 내보내, KFlash의 처리량, 일정 시간에 처리하는 양의 변화는 약 −5%~+3%에 머물렀다. 여러 요청을 함께 처리하는 일부 경로는 요청별 트리 대신 체인을 검증한다.
4. 기본 활성화와 기존 방식 전환
KFlash는 블록 드래프터를 쓰는 모델에서 기본으로 켜진다. 사용자는 아래 명령으로 로컬 서버를 실행할 수 있다.
kapitsa serve # chat + OpenAI/Anthropic APIs at http://127.0.0.1:8000기존 방식과 비교하려면 환경 변수 NI_KFLASH=0으로 체인 검증을 다시 켤 수 있다. 서버 로그에는 요청 뒤에 선택한 트리 크기와 예상·실제 생성 토큰 수, 비용 기록이 남아 자신의 맥에서 동작을 살펴볼 수 있다.
KFlash의 이점은 후보 탐색으로 얻는 처리량이며, 그 폭은 답변 길이와 모델 구조, 검증 비용에 따라 달라진다.