入力から答えを計算するソフトウェアであるローカル推論エンジンのKapitsaが、Appleシリコンで回答生成を速めるKFlashを標準機能として提供する。Macでコーディングツールを使う開発者は、小さなモデルが出した候補を1列ではなくツリー状にまとめて検査し、大きなモデルの1回の計算でより多くのトークンを生成できる。
コーディングツールやローカルモデルを使う開発者は、同じ計算パスで候補をより多く活用できる。プロジェクトが公開したM4 Proでの測定では、512トークンのコーディング回答の処理速度が、3つのモデルでそれぞれ3.2~6.0%向上した。
1. 候補の次の選択肢まで確認
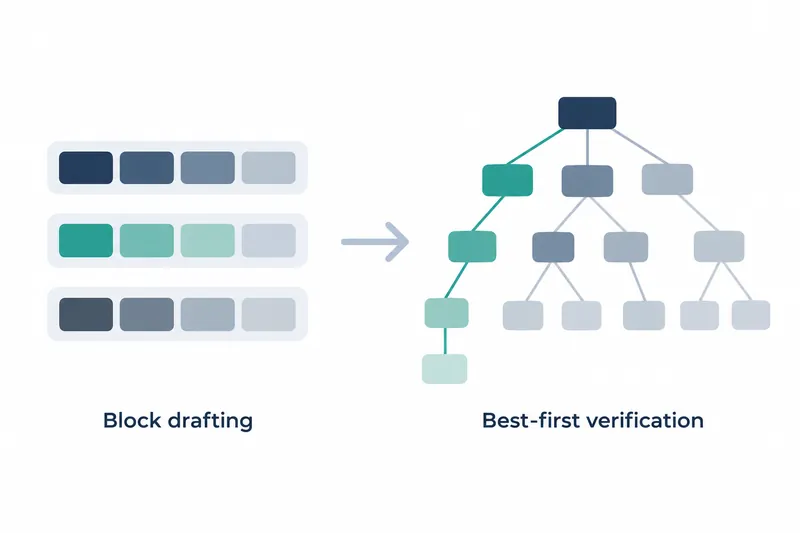
次のトークン候補を先に作る小さなモデルであるブロックドラフターは、次の7位置の候補をまとめて予測する。大きなモデルは直前に生成したトークンを加えて8行を検証するが、候補を1列につなぐ従来のチェーン構造では、最初に間違えたトークン以降の行を捨てる。DFlashとDFlash2は各位置で16候補を可能性の高い順に並べるため、最初の選択が間違っても、大きなモデルが求める候補がリストに残っている場合がある。
KFlashは分岐点で2番目の選択肢も調べるように、候補とスコアから可能性の高い枝を優先してツリーを作る。大きなモデルは同じ8行の計算で、自ら生成したトークンと一致する最も長い枝をたどる。文書の説明図では、大きなモデルが直接追加するトークンも含め、チェーンが2個、ツリーが4個のトークンを出力する。
候補を出すモデルを再学習する必要はない。公開済みのドラフターがすでに提供している候補リストとスコアを、別の方法で活用することが変更の核心だ。
2. デバイスごとのコストに合わせて検証サイズを選択
ツリーサイズを決める計算予算の仕組みは、検証する行数ごとに予想生成トークン数とGPU時間を見積もり、処理速度に有利なサイズを選ぶ。ドラフターの確信度は実際に採用された候補の記録で補正し、計算コストも各Macで測定する。
プロジェクトの測定で、Qwen3.6-35B-A3Bは散文に平均4.8行、コードとエージェント応答に約6~7行を選択した。比較実験全体のツリー実行60回では、予測したサイクル当たりのトークン数と実測値の差は平均2.6%だった。
Apple GPUの行列計算は8行のまとまりを活用する。毎回すべてのパラメーターを計算する密なモデルでは、重みをまとめて読み込むため1行と8行の検証コストが近く、すでに支払っていた計算量を別の候補に使う効果がある。
3. コーディング回答で確認した速度の変化
プロジェクトの発表によると、MacBook Pro M4 Pro 48GBで512トークンのコーディング回答の速度が3モデルとも向上した。macOS 27.0.1で、高出力モードと電源接続の状態でGPUを排他的にロックし、KFlash直前のビルドと適用後のビルドを交互にそれぞれ5回測定した。
表:512トークンのコーディング回答の処理速度
条件:MacBook Pro M4 Pro 48GB、macOS 27.0.1、高出力モード・電源接続、GPUの排他ロック、512トークンのコーディング回答、毎回最も確率の高いトークンを選択、ビルドごとに5回交互実行、プロジェクト独自の測定
単位:トークン/秒
| モデル | 以前のビルド | KFlash | 変化(%) |
|---|---|---|---|
| Qwen3.5-4B | 179.3 | 188.5 | +5.1 |
| Qwen3.8-27B | 61.0 | 64.7 | +6.0 |
| Qwen3.6-35B-A3B | 176.1 | 181.7 | +3.2 |
短い回答では、一度に生成するトークンが増える利点が追加の計算コストを上回った。モデル全体を使う密なモデルではサイクル当たりのGPU時間が1~6%増え、一部のエキスパートだけを選んで使う混合エキスパートモデルの35Bでは、行ごとに異なるエキスパートを呼び出すため6~12%増えた。
長いエージェント会話では、チェーンもすでにサイクル当たり2.9~6.4個のトークンを出力するため、KFlashのスループット、つまり一定時間に処理する量の変化は約−5%~+3%にとどまった。複数のリクエストをまとめて処理する一部の経路では、リクエストごとのツリーではなくチェーンを検証する。
4. 標準で有効化、従来方式への切り替えも可能
KFlashはブロックドラフターを使うモデルで標準で有効になる。ユーザーは以下のコマンドでローカルサーバーを起動できる。
kapitsa serve # chat + OpenAI/Anthropic APIs at http://127.0.0.1:8000従来方式と比較するには、環境変数NI_KFLASH=0でチェーン検証を再び有効にできる。サーバーログにはリクエスト後に選択したツリーサイズ、予想と実際の生成トークン数、コストの記録が残るため、自分のMacでの動作を確認できる。
KFlashの利点は候補探索で得られるスループットであり、その幅は回答の長さ、モデル構造、検証コストによって変わる。