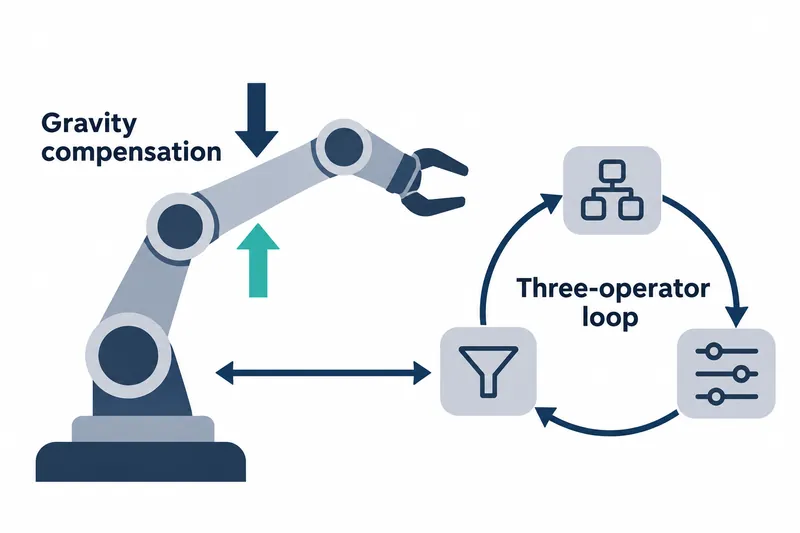
NVIDIA Holoscan 5 为原本用于传感器处理的平台加入机器人控制,将读取机械臂状态、计算力矩并发送至电机的过程组织为一张执行图。NVIDIA 公布的教程在真实机械臂上演示重力补偿循环:人推动机械臂时,电机承担重量,机械臂则柔顺地响应手部动作。
机器人开发者可以此为起点,在同一种编程模型中组合控制与传感器处理。公布的测量也展示了核心分配如何影响控制延迟。
1. Holoscan 5 为控制循环带来了什么
Holoscan 5 为快速重复的机器人控制和处理大量传感器数据的任务提供相同的开发方式。开发者将各处理阶段构建为算子,即独立执行的处理单元,再用图连接数据流动的顺序。这种设计让控制与图像分析即使按不同周期运行,也能减少分别学习配置方式的负担。
把连续任务放入一个称为分区的执行单元后,就由同一线程依次处理。它相当于让同一负责人连续完成工作,而不是每个阶段都转交给另一线程。编译器会将这种安排记录在执行计划中,开发者可在启动设备前查看任务布局与内存准备计划。
2. 从状态读取到电机指令的三个阶段
教程使用 Seeed Studio reBot Arm B601-DM。NVIDIA 表示,与主要用于位置控制的低价爱好者级舵机,也就是按指令控制运动的电机不同,这款设备的执行器适合力矩控制与感测。
循环分为三个阶段:按固定周期读取七个电机的关节状态,用 Pinocchio 计算重力力矩,以及将指令发送至电机。Pinocchio 根据机器人模型和当前姿态,计算每个关节支撑重力所需的转动力矩。
演示每秒运行 400 次,在算出的重力力矩上叠加微弱的恢复力,即让机械臂回到参考姿态的力,以及抑制运动的阻尼。这使机械臂既能支撑自身重量,又能柔顺地随人的推力移动。
原文展示了将三个算子放入同一分区、把队列深度设为 1 并丢弃旧数据的示例。因此,可以将其配置为在计算延迟时避免陈旧的关节状态不断积压。
graph = hsdk.Graph("rebot-gravity", default_clock=hsdk.RealtimeClock)
source = graph.op(JointStateSourceOp, "joint_feedback")
gravity = graph.op(PinocchioGravityOp, "gravity", **controller.parameters.operator_kwargs())
sink = graph.op(MotorCommandSinkOp, "motor_commands")
graph.add_flow(source.state, gravity.state, queue_depth=1, queue_policy=hsdk.QueuePolicy.DROP_OLDEST)
graph.add_flow(gravity.command, sink.command, queue_depth=1, queue_policy=hsdk.QueuePolicy.DROP_OLDEST)
graph.partition("control").add(source).add(gravity).add(sink)
3. 执行计划与安全停机
应用先编译图并生成执行计划,再初始化电机与模型,随后进入异步执行,即不等待前一项任务完成的运行方式。示例配置为在计划为空时抛出包含摘要的错误。NVIDIA 表示,这个顺序有助于在启动真实设备前发现图配置问题。
监测指令完成情况的看门狗若在 100 毫秒内未发现已完成的电机指令批次,就会尝试禁用电机并停止图。退出回调,即退出时自动调用的函数,也会禁用电机。
示例在 Linux 上使用 Python 3.12 或更高版本运行。
同一仓库还提供了第二个 Python 示例,可在指定目标位置与方向的同时柔顺地响应接触。它为从手动引导的重力补偿扩展到保持目标姿态的控制提供了起点。
4. 核心绑定与否带来的延迟差异
NVIDIA 使用执行分析工具 Nsight Systems 测量算子执行情况。下列延迟从进入第一个算子算起,到进入最后一个算子为止,不包含电机指令发送。每次运行采集超过一百万个周期,排除顺序测量的前 10 秒,并保留异常值。
表中的 p50 是一半测量值不超过它的中位数,p99.99 则是 99.99% 的测量值不超过的数值。中位数反映通常的响应,高百分位数则用于观察偶尔出现的长延迟。
表:重力补偿循环各实现的延迟
条件:依据公司公布的数据,使用 reBot Arm B601-DM 重力补偿演示;绑定运行同时采用核心绑定,即将任务固定到特定 CPU 核心,以及核心隔离,即阻止其他任务使用该核心的设置
单位:微秒
| 实现 | p50 | p99.99 | p99.999 |
|---|---|---|---|
| HSDK C++ 绑定 | 7.1 | 17.2 | 20.7 |
| HSDK C++ 未绑定 | 15.3 | 86.6 | 133.4 |
| HSDK Python 绑定 | 93.0 | 142.6 | 1,014.0 |
| HSDK Python 未绑定 | 113.8 | 1,373.5 | 3,134.1 |
依据公司公布的数据,同时应用核心绑定与隔离后,观测到的 p99.99 延迟在 C++ 中降低约 5 倍,在 Python 中降低 9.6 倍。但 Python 绑定运行的 p99.999 仍为 1,014.0 微秒,远高于中位数。这表明,缩短通常响应与管理罕见延迟需要同时考虑。
5. 降低延迟,也需要更精细的运维
两种实现均使用同一套基于 C++ 的计算器,但 NVIDIA 解释,Python 执行与对象分配,即为程序获取所需内存等操作,会带来额外开销。对于必须在短时间内完成的控制,用 C++ 调整内存分配与系统调用,也就是向操作系统请求服务的操作,优势更明显。公司表示,对于处理阶段由 CUDA 实现、耗时数毫秒或数十毫秒的 GPU 感知任务,Python 也是实用的组织工具。
获得低延迟的代价,是需要将核心分配给控制任务,并承担管理其他任务干扰的运维负担。本次测量预留了控制与辅助任务使用的物理核心,不让其他应用使用,但仍无法排除中断,即暂时打断 CPU 处理的信号,以及部分内核任务,即由操作系统核心执行的工作。
Holoscan 5 的关键,在于让机器人控制采用与传感器处理相同的执行模型,并让开发者能够预先查看和测量其执行过程。