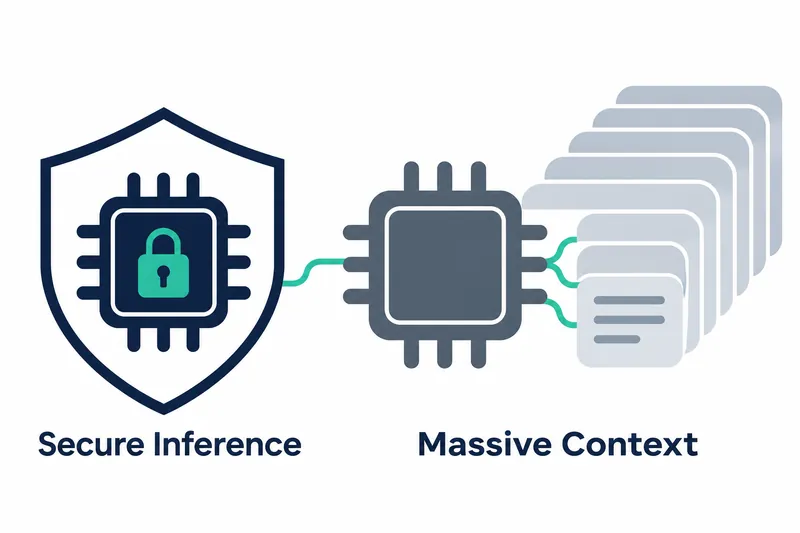
谷歌为第8代 TPU 产品系列新增了可在处理过程中保护敏感数据的 8tx,以及面向大规模上下文和高机架计算密度的 8i Max。企业和政府可考虑将安全型用于安全要求较高的推理与小规模训练,将大规模上下文型用于多个智能体处理长上下文的任务。
1. 新增两款系统,提供四种选择
谷歌在11月9日的公告中,继4月发布训练用 TPU 8t 和实时推理用 TPU 8i 后,又新增了两款系统。该公司表示,这是首次在一年内推出四款 TPU 系统。它没有分别设计新芯片,而是通过为现有芯片搭配不同的安全、内存和网络配置来扩展用途。
谷歌公布的规格表包含第8代产品系列的部分性能对比。以下数据以将多颗芯片组合在一起的 Pod 系统为单位,对比2025年代的 Ironwood 与2026年代的 TPU 8t,算力按 FP4(4位浮点运算)计算。
表:TPU 8t 与 Ironwood 规格
条件:谷歌训练系统规格对比。以 Ironwood(2025)和 TPU 8t(2026)的 Pod 配置为准,算力采用 FP4,带宽为每颗芯片的数值。
| 项目 | Ironwood (2025) | TPU 8t (2026) |
|---|---|---|
| 每个 Pod 的芯片数 | 9,216 | 9,600 |
| 每个 Pod 的 FP4 算力 (EFlops) | 42.5 | 121 |
| 每颗芯片的双向扩展带宽 (Tb/s) | 9.6 | 19.2 |
| 每颗芯片的横向扩展网络带宽 (Gb/s) | 100 | 400 |
根据表中数据计算,每个 Pod 的芯片数增加约4.2%,但 FP4 算力约为2.85倍,每颗芯片的双向扩展带宽为2倍,横向扩展网络带宽为4倍。相比增加芯片数量,这种配置更侧重提升算力与通信带宽。按公司公布的数据,8t 每个 Pod 的算力接近上一代的3倍。
图:TPU 8t 相对 Ironwood 的规格倍数。条件:将上表 TPU 8t 的数值除以 Ironwood 对应项目的数值。小数倍数为四舍五入后的近似值,条形长度与倍数成正比。单位:Ironwood 各项目 = 1
Ironwood 各项目基准                 ████             1
TPU 8t 每个 Pod 芯片数              ████▏            约 1.04
TPU 8t 每个 Pod FP4 算力            ███████████▍     约 2.85
TPU 8t 每颗芯片双向扩展带宽         ████████         2
TPU 8t 每颗芯片横向扩展网络带宽 ████████████████ 4谷歌还在11月的公告中表示,相比上一代,8t 的训练性能最高达到2.7倍,8i 的推理性价比提高了80%。两者分别针对训练处理能力和推理成本效率进行了改进。
2. 8tx 通过硬件保护使用中的数据
与存储或通过网络传输的数据不同,使用中的数据需要在内存中解密。8tx旨在这一处理阶段也通过硬件层保护和隔离敏感数据及模型权重。谷歌将受监管行业的企业、政府,以及将专有模型或自主智能体与敏感数据结合使用的用户列为目标群体。
它采用与训练系统相同的芯片,主机使用第5代 AMD EPYC,并结合了为实时推理开发的低延迟 Boardfly 网络。
按公司公布的数据,8tx 的延迟最低可降至 8t 的一半,且安全功能几乎不会造成性能损失。谷歌解释,它结合了训练级算力与快速推理网络,因此也适合小规模训练。
谷歌表示,无需将内部数据迁移到其他集群,即可进行模型微调(针对特定任务的额外训练)、蒸馏(将大模型知识转移到小模型的训练)和强化学习(将行为结果的奖励纳入训练)。这种方式在减少敏感数据移动的同时,可在同一系统中持续开展模型运行与定制训练。
3. 8i Max 应对内存瓶颈与机架密度需求
当多个智能体处理完整代码或长时间视频等长输入时,向计算单元供给数据的速度可能成为瓶颈。8i Max将两颗低延迟 8i 芯片集成在一个封装中,同时增加算力与内存。
表:TPU 8i Max 相对基础版 TPU 8i 的配置扩展
条件:依据谷歌公告,对比将两颗 TPU 8i 芯片集成于一个封装的 TPU 8i Max 与基础版 TPU 8i 的规格。
单位:相对基础版 TPU 8i 的倍数
| 项目 | TPU 8i Max |
|---|---|
| 算力 | 2 |
| 片上 SRAM 容量 | 2 |
| 高带宽内存带宽 | 2 |
按公司公布的数据,三个项目均翻倍。该设计并非仅增加算力,而是将所需数据放在更近的位置并快速供给,以减少处理长上下文时的等待。
基础版 8i配备288GB高带宽内存,以及作为芯片内部高速工作内存的384MB SRAM。谷歌表示,SRAM 容量是上一代的3倍。
谷歌表示,Boardfly 将芯片间通信的最大跳数减少了50%以上;用于加速集合通信的片上引擎则使片上延迟最高降低至原来的1/5。集合通信指汇集或分发多颗芯片数据的通信操作。这些改进侧重减少多颗芯片交换数据时的等待时间。
4. 通过软件降低使用门槛与闲置成本
谷歌在软件支持公告中表示,已开源 TorchTPU,使 PyTorch 代码无需重写即可在 TPU 上运行。此举让开发者能够保留现有开发方式并更换加速器,从而降低使用门槛。
Agent Compute Engine 会在智能体等待外部工具或人员响应时暂停会话,并将工作内存移至芯片外。这项功能可减少非计算期间资源被占用的成本。
TPU Sync 将芯片内存、主机内存、共享存储和网络视为统一的内存层。谷歌宣布,它支持大型键值缓存的迁移和强化学习权重同步,使缓存传输延迟与首个词元生成时间减少了90%以上。键值缓存是保存此前上下文计算结果的内存。
谷歌云的 Kubernetes 托管服务 GKE 提供动态分区功能,可按任务规模划分资源组,并根据任务需要将 TPU 组扩大合并或缩小拆分。按公司公布的数据,任务启动速度最高提升至5倍,故障恢复速度最高提升至4.5倍。
收益与代价都体现在系统配置中。8i Max 在相同机架面积内提供更多算力,但这种密度是通过部署两倍的芯片实现的。本次设计的核心在于,只有同时扩展内存带宽和数据移动管理,才能减少计算资源的等待时间。
第8代 TPU 的扩展超越了芯片性能竞争,转向根据安全需求与上下文规模选择数据中心系统。