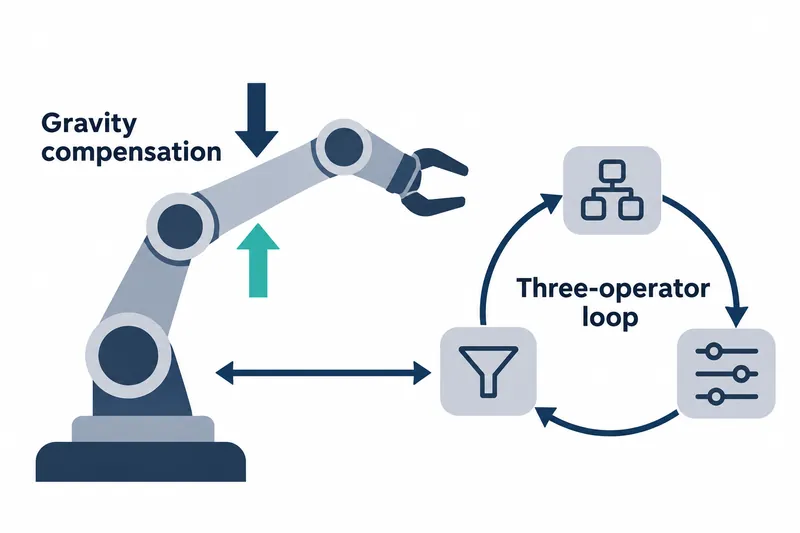
NVIDIA Holoscan 5は、センサー処理に使われてきたプラットフォームにロボット制御を加え、アームの状態を読み取り、トルクを計算してモーターに送る過程を1つの実行グラフに構成できるようにした。NVIDIAが公開したチュートリアルは、人がアームを動かす際に重さをモーターが支え、手の動きには柔らかく反応する重力補償ループを実機で実演する。
ロボット開発者はこの例を出発点に、制御とセンサー処理を同じプログラミングモデルで組み合わせられる。公開された測定は、コア配置が制御遅延に与える影響も示す。
1. Holoscan 5が制御ループに加えたもの
Holoscan 5は、高速に繰り返すロボット制御と大量のセンサーデータ処理に、共通の開発方式を提供する。開発者は各処理段階を、独立して実行する処理単位であるオペレーターとして作り、データが流れる順序をグラフでつなぐ。制御と画像解析を異なる周期で動かしながらも、別々の構成方法を学ぶ負担を減らす設計だ。
連続する処理を、実行のまとまりである1つのパーティションに置くと、1つのスレッドが順番に処理する。段階ごとに別のスレッドへ仕事を渡す代わりに、同じ担当者が続けて処理するようなものだ。コンパイラーはこの配置を実行計画に記録し、開発者は機器を起動する前に処理の配置とメモリーの準備計画を確認できる。
2. 状態の読み取りからモーター指令までの3段階
チュートリアルの対象はSeeed Studio reBot Arm B601-DMだ。NVIDIAは、この機器のアクチュエーターについて、指令に応じて動きを制御するモーターのうち、位置制御が中心の安価なホビー用サーボとは異なり、トルク制御とセンシングに適すると説明する。
ループは、一定周期で7つのモーターの関節状態を読む段階、Pinocchioで重力トルクを計算する段階、指令をモーターに送る段階に分かれる。Pinocchioはロボットモデルと現在の姿勢から、各関節で重力を支えるために必要な回転力を求める。
デモは毎秒400回実行され、計算した重力トルクに、アームを基準姿勢へ戻す弱い復元力と、動きを落ち着かせる減衰を加える。アームが自重を支えつつ、人が押す力には柔らかく動く構成だ。
原文は、3つのオペレーターを1つのパーティションに入れ、キューの深さを1に設定して古いデータを捨てる例を示す。このため、計算が遅れた際に古い関節状態が次々とたまる状況を避ける構成にできる。
graph = hsdk.Graph("rebot-gravity", default_clock=hsdk.RealtimeClock)
source = graph.op(JointStateSourceOp, "joint_feedback")
gravity = graph.op(PinocchioGravityOp, "gravity", **controller.parameters.operator_kwargs())
sink = graph.op(MotorCommandSinkOp, "motor_commands")
graph.add_flow(source.state, gravity.state, queue_depth=1, queue_policy=hsdk.QueuePolicy.DROP_OLDEST)
graph.add_flow(gravity.command, sink.command, queue_depth=1, queue_policy=hsdk.QueuePolicy.DROP_OLDEST)
graph.partition("control").add(source).add(gravity).add(sink)
3. 実行計画と安全停止
アプリケーションはグラフをコンパイルして実行計画を作った後、モーターとモデルを初期化し、先行処理の完了を待たない非同期実行に入る。例では、計画が空なら概要を含むエラーを出す構成になっている。NVIDIAは、この順序が実機を起動する前のグラフ設定の問題確認に役立つと説明する。
指令の完了を監視するウォッチドッグは、100ミリ秒にわたり完了したモーター指令のまとまりがなければ、モーターの無効化を試みてグラフを停止する。終了時に自動で呼ばれる関数である終了コールバックも、モーターを無効化する。
例はLinux上でPython 3.12以上を使って実行する。
同じリポジトリーには、目標の位置と向きを指定しながらも接触に柔軟に反応する、2つ目のPython例がある。手で導く重力補償から、目標姿勢を維持する制御へ広げる出発点となる。
4. コア固定の有無による遅延時間
NVIDIAは実行解析ツールのNsight Systemsでオペレーターの実行を測定した。以下の遅延時間は最初のオペレーターへの進入から最後のオペレーターへの進入までで、モーター指令の送信は含まない。各実行で100万サイクル以上を収集し、逐次測定の最初の10秒は除外する一方、外れ値は残した。
表のp50は測定値の半分がそれ以下となる中央値で、p99.99は99.99%がそれ以下となる値だ。中央値が普段の応答を示すのに対し、高いパーセンタイル値は、まれに長引く遅延を確認する指標となる。
表:重力補償ループの実装別遅延時間
条件:同社発表に基づくreBot Arm B601-DMの重力補償デモ。固定実行には、処理を特定のCPUコアに結び付けるコア固定と、他の処理にそのコアを使わせないコア分離を適用。
単位:マイクロ秒
| 実装 | p50 | p99.99 | p99.999 |
|---|---|---|---|
| HSDK C++ 固定 | 7.1 | 17.2 | 20.7 |
| HSDK C++ 非固定 | 15.3 | 86.6 | 133.4 |
| HSDK Python 固定 | 93.0 | 142.6 | 1,014.0 |
| HSDK Python 非固定 | 113.8 | 1,373.5 | 3,134.1 |
同社発表では、コア固定と分離を併用すると、観測されたp99.99遅延はC++で約5倍、Pythonで9.6倍の改善となった。一方、Pythonの固定実行のp99.999は1,014.0マイクロ秒で、依然として中央値より大きい。普段の応答を短くすることと、まれな遅延を管理することを併せて見る必要がある結果だ。
5. 低遅延と引き換えに求められる精緻な運用
両実装は同じC++ベースの計算器を使うが、NVIDIAはPythonの実行や、プログラムが使うメモリーを確保するオブジェクト割り当てなどに追加コストがかかると説明する。短時間で完了させる必要がある制御では、C++でメモリー割り当てや、OSにサービスを要求するシステムコールを調整する利点が大きくなる。処理段階がCUDAで実装され、ミリ秒から数十ミリ秒かかるGPU認識処理では、Pythonも実用的な構成手段になるというのが同社の説明だ。
低遅延を得る代わりに、コアを制御用に割り当て、他の処理の干渉を管理する運用負担が生じる。今回の測定では、制御用と補助処理用の物理コアを他のアプリケーションが使わないよう予約した。ただし、CPUの処理を一時中断させる信号である割り込みや、OSの中核部分が行う一部のカーネル処理まで排除したわけではない。
Holoscan 5の要点は、ロボット制御をセンサー処理と同じ実行モデルに載せ、その実行過程を開発者が事前に確認し、測定できるようにしたことにある。