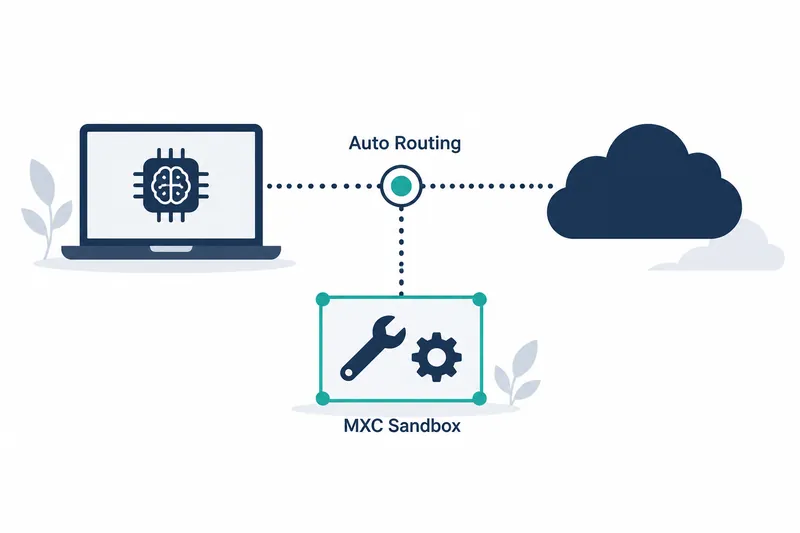
GitHub Copilot 预告将推出自动选择在设备还是云端执行模型的功能,开发者需将这一选择与命令获准使用的权限分别判断。
1. 自动部署计划于 10 月底前引入
微软在 2026 年 10 月 7 日的公告中表示,计划在当月底前引入自动部署。本地模型和沙箱工具正逐步推出,这并不意味着它们已全面启用,也不意味着本地推理是默认选项。沙箱是限制命令可访问的文件和网络的执行区域。
公告的[“使用本地模型的两种方式”一节](https://commandline.microsoft.com/local-models-sandboxed-tools-github-windows/)明确列出,适用对象为 Copilot 命令行工具(CLI)、桌面应用和 Visual Studio Code(VS Code)。
自动模式在多轮对话期间,会根据任务上下文及已计算信息的状态决定执行位置。开发者仍可手动选择本地模型。
2. 需结合本地模型大小与任务性能判断
MAI Code 1.1 Flash 本地版通过降低数值表示精度的量化来减少内存占用。它还采用推测解码,由主模型验证小模型提出的输出片段。开发商微软称,这一组合可改善响应性。
上下文长度是一次处理的输入和对话量。token 是文本处理单位,k 表示千,因此 256k 表示 256000 个 token。
[微软设备测量](https://commandline.microsoft.com/local-models-sandboxed-tools-github-windows/)使用的 Surface Laptop Ultra 配备最高 128GB 统一内存,即 CPU 与 GPU 共享的物理内存。首发模型在上下文长度为 256k 时最多使用 75.5GB。模型文件为 53GB,比云端高精度版本小 80%。
任务成功率核查:从原模型切换为设备端量化模型后,SWE-Bench Verified 得分从 72.6% 变为 70.80%,终端任务评估 Terminal-Bench 2.1 从 62.9% 变为 66.29%。两项评估的变化方向相反,因此不能断定缩小体积对性能只有单一方向的影响。
吞吐量测量条件为 2026 年 10 月 5 日、Windows 64 位 ARM 环境下的运行时 llama.cpp·CUDA,以及滑动窗口推测解码。在 64k 时测得每秒 923.5 个 token,但正文称其为输入吞吐量,测试注释则称其为输出生成吞吐量,测量类型不明确。仅凭这一数值难以判断实际响应性的改善幅度。
不能仅凭文件大小判断运行余量。操作系统和开发工具也会占用内存,推测解码还需要额外的工作内存。用于存储此前 token 计算状态的缓存也会随上下文增长而变大。
3. 多模型研究结果不同于本地部署性能
GitHub 于 2026 年 9 月 4 日公布的 Project HydraFusion 是多模型编排研究预览。它会选择由单一模型解决、在草稿未达标准时交给更强模型,或经其他模型审查后修改等路径。10 月的公告提出了将其扩展至本地与云端的方向。
在 [HydraFusion 的离线评估](https://github.blog/ai-and-ml/github-copilot/project-hydrafusion-frontier-quality-via-multi-model-orchestration/)中,相较于 Claude Opus 5,终端任务的估算任务成本降低 67%,通过正确性验证的任务比例提高 4.9 个百分点。
成本是包含起草、审查、修改、切换至更强模型、重试和替代执行的总估算值,并非单次模型调用价格,也不是本地设备的总运营成本。
评估核查:使用了 TerminalBench 2.1、DeepSWE、CheckpointBench。最后一项是基于实际 Copilot 会话构建的内部评估,研究团队使用这三套评估集反复调整配置。结果来自最优配置:生成答案的推理设置统一为“中等”,输入、工具、执行限制、价格和评分条件也保持一致。结果受限于相应评估版本及模型配置,不能直接与设备端模型的实际使用成本或速度比较。
研究预览建议先尝试范围明确、可通过首次请求完整委托的编码任务。持续多轮长对话的性能是下一步改进目标。
以下命令用于启用命令行工具的实验功能。
/experimental on4. 沙箱限制的是工具权限,而非模型
用于隔离工具执行的[微软执行容器](https://blogs.windows.com/windowsdeveloper/2026/10/07/microsoft-execution-containers-policy-driven-containment-for-ai-agents/)于 10 月 7 日正式推出。开发者或组织指定允许访问的文件和网络目标后,由操作系统落实边界。这种方式从外部划定工作区域,防止智能体自行扩大权限。
Copilot 在 Windows 上使用轻量级进程隔离。启用沙箱后,shell 命令及默认配置下的本地工具服务器、语言服务器会被纳入隔离范围。
根据 [Copilot 的隔离范围说明](https://commandline.microsoft.com/local-models-sandboxed-tools-github-windows/),内置文件工具接受助手内部的策略检查,并非由操作系统隔离的子进程。远程工具服务器也在本地沙箱之外。
本地推理不意味着整个会话离线运行。仪表板示例也使用外部服务的议题和变更请求信息,因此并不保证离线。
5. 也支持手动选择本地模型
可通过 Windows 机器学习提供程序或兼容 OpenAI 的本地端点手动选择模型。
决定是否采用时,应分别核查模型执行位置、完成任务的能力以及各工具的权限边界。