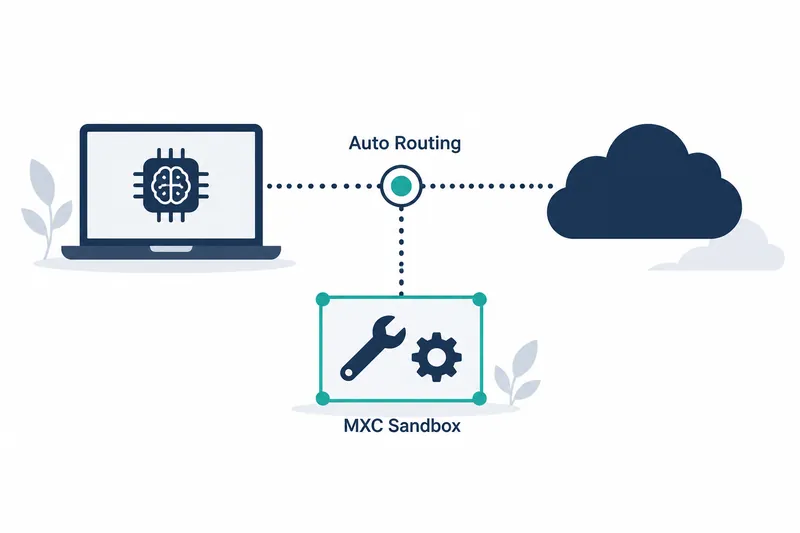
GitHub Copilotは、デバイスとクラウドのどちらでモデルを実行するかを自動で選ぶ機能を予告しており、開発者はこの選択とコマンドに許可する権限を別々に判断する必要がある。
1. 自動配置は10月末までに導入される予定
Microsoftの2026年10月7日の発表では、自動配置を同月末までに導入する予定だとした。ローカルモデルとサンドボックスツールは順次展開中で、すでに全面適用された、あるいはローカル推論が既定という意味ではない。サンドボックスは、コマンドがアクセスするファイルやネットワークを制限する実行領域だ。
発表の[「ローカルモデルを使う2つの方法」の節](https://commandline.microsoft.com/local-models-sandboxed-tools-github-windows/)は、対象をCopilotのコマンドラインツール(CLI)、デスクトップアプリ、Visual Studio Code(VS Code)と明記している。
自動モードは、複数回の対話中に作業の文脈と計算済み情報の状態を見て実行場所を決める。開発者がローカルモデルを直接選ぶ選択肢も残る。
2. ローカルモデルのサイズとタスク性能を併せて見る必要がある
MAI Code 1.1 Flashのローカル版は、数値表現の精度を下げる量子化でメモリを削減する。小さなモデルが提案した出力の断片を本体モデルが検証する投機的デコーディングも使う。この組み合わせで応答性を改善するというのが、開発元Microsoftの説明だ。
コンテキスト長は、一度に扱う入力や対話の量を指す。トークンはテキスト処理の単位で、kは千単位なので、256kは25万6000トークンを意味する。
[Microsoftのデバイス測定](https://commandline.microsoft.com/local-models-sandboxed-tools-github-windows/)に使ったSurface Laptop Ultraは、最大128GBの統合メモリ、つまりCPUとGPUで共有する物理メモリを備えていた。初出荷モデルはコンテキスト長256kで最大75.5GBを使った。モデルファイルは53GBで、クラウドの高精度版より80%小さかった。
タスク成功率の確認:元モデルからデバイス向け量子化モデルに変えると、SWE-Bench Verifiedのスコアは72.6%から70.80%に、ターミナル作業の評価であるTerminal-Bench 2.1は62.9%から66.29%に変わった。2つの評価の変化が逆なので、容量削減の性能への影響を一方向に断定できない。
スループットの測定条件は、2026年10月5日、Windows 64ビットArm環境の実行ランタイムllama.cpp・CUDAと、スライディングウィンドウ投機的デコーディングだ。64kで毎秒923.5トークンを記録したが、本文は入力処理量、試験の注記は出力生成処理量としており、測定の種類が不明確だ。この数値だけで体感応答性の改善幅を判断するのは難しい。
実行余力はファイルサイズだけでは判断できない。OSや開発ツールもメモリを使い、投機的デコーディングには追加の作業メモリが必要だ。過去のトークンの計算状態を保存するキャッシュも、コンテキストが長くなるほど大きくなる。
3. 複数モデルの研究結果はローカル配置の性能とは異なる
GitHubが2026年9月4日に公開したProject HydraFusionは、複数モデルの協調制御を研究するプレビューだ。1つのモデルで解決するか、下書きが基準に達しなければより強力なモデルに渡すか、別のモデルによるレビューを経て修正するかを選ぶ。10月の発表は、これをローカルとクラウドに拡張する方向を示した。
[HydraFusionのオフライン評価](https://github.blog/ai-and-ml/github-copilot/project-hydrafusion-frontier-quality-via-multi-model-orchestration/)では、Claude Opus 5に比べてターミナル課題の推定タスクコストが67%減り、正解と検証された課題の割合は4.9%ポイント上がった。
コストは、下書き、レビュー、修正、上位モデルへの切り替え、再試行、代替実行をすべて合算した推定値だ。単一モデルの呼び出し料金や、ローカルデバイスの総運用費ではない。
評価の確認:TerminalBench 2.1、DeepSWE、CheckpointBenchを使った。最後のものは実際のCopilotセッションを基に作った内部評価で、研究チームは3つの評価セットを用いて構成を繰り返し調整した。結果は、回答生成時の推論設定を同じ「中」レベルにし、入力、ツール、実行制限、価格、採点条件も統一した最適構成の数値だ。この評価版とモデル構成に限った結果なので、デバイスモデルの実利用コストや速度とは直接比較できない。
研究プレビューでは、最初の1回の依頼で任せられる、範囲が明確なコーディング課題から試すことを推奨している。長い対話を何度も続ける性能は、次の改善対象だ。
コマンドラインツールの実験機能を有効にするコマンドだ。
/experimental on4. サンドボックスはモデルではなくツールの権限を制限する
ツール実行を隔離する[Microsoft Execution Containers](https://blogs.windows.com/windowsdeveloper/2026/10/07/microsoft-execution-containers-policy-driven-containment-for-ai-agents/)は10月7日に正式提供された。開発者や組織が許可するファイルとネットワーク接続先を決めると、OSがその境界を適用する。エージェントが自ら権限を広げられないよう、外部から作業領域を定める方式だ。
CopilotはWindowsで軽量なプロセス隔離を使う。サンドボックスを有効にすると、シェルコマンドと、既定設定のローカルツールサーバー・言語サーバーが隔離対象になる。
[Copilotの隔離範囲の説明](https://commandline.microsoft.com/local-models-sandboxed-tools-github-windows/)によると、組み込みファイルツールはアシスタント内部のポリシー検査の対象であり、OSが隔離した子プロセスではない。リモートツールサーバーもローカルサンドボックスの外にある。
ローカル推論は、セッション全体のオフライン動作を意味しない。ダッシュボードの例も外部サービスのイシューや変更リクエストの情報を使うため、オフラインの保証ではない。
5. ローカルモデルの直接選択にも対応する
直接選択は、Windows Machine LearningプロバイダーやOpenAI互換のローカルエンドポイントを通じてサポートされる。
導入判断では、モデルの実行場所と課題の完遂能力、ツールごとの権限境界を別々に確認する必要がある。