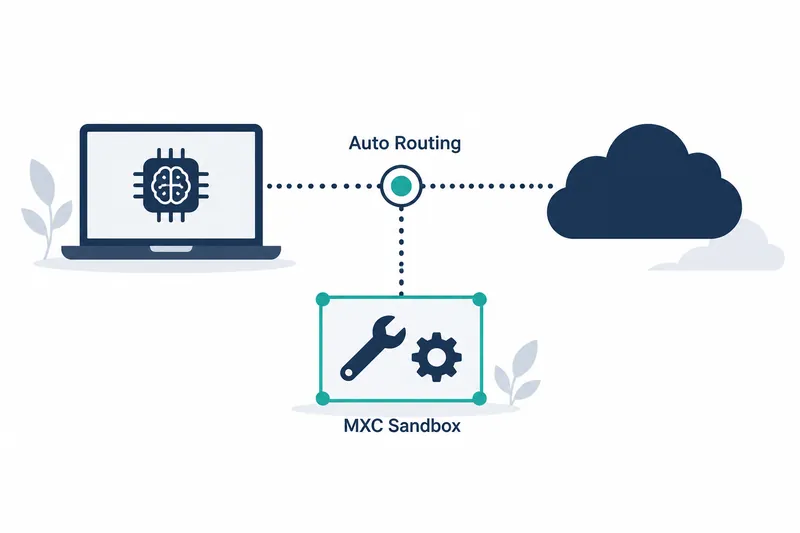
깃허브 코파일럿(GitHub Copilot)은 기기와 클라우드 중 모델을 실행할 곳을 자동으로 고르는 기능을 예고했으며, 개발자는 이 선택과 명령에 허용할 권한을 따로 판단해야 한다.
1. 자동 배치는 10월 말까지 도입될 예정이다
마이크로소프트의 2026년 10월 7일 발표는 자동 배치를 그달 말까지 도입할 예정이라고 밝혔다. 로컬 모델과 샌드박스 도구는 순차 배포 중으로, 이미 전면 적용됐거나 로컬 추론이 기본값이라는 뜻은 아니다. 샌드박스는 명령이 접근할 파일·네트워크를 제한하는 실행 구역이다.
발표의 [‘로컬 모델을 쓰는 두 방식’ 절](https://commandline.microsoft.com/local-models-sandboxed-tools-github-windows/)은 적용 대상을 코파일럿 명령줄 도구(CLI), 데스크톱 앱, 비주얼 스튜디오 코드(VS Code)로 명시한다.
자동 모드는 여러 차례 대화하는 동안 작업 맥락과 이미 계산해 둔 정보의 상태를 보고 실행 위치를 정한다. 개발자가 직접 로컬 모델을 고르는 선택지도 남는다.
2. 로컬 모델의 크기와 작업 성능을 함께 봐야 한다
마이 코드 1.1 플래시 로컬 버전은 숫자 표현의 정밀도를 낮추는 양자화로 메모리를 줄인다. 작은 모델이 제안한 출력 조각을 본 모델이 검증하는 추측 디코딩도 쓴다. 이 조합으로 응답성을 개선한다는 것이 개발사 마이크로소프트의 설명이다.
문맥 길이는 한 번에 다루는 입력·대화의 양이다. 토큰은 텍스트 처리 단위이고 k는 천 단위여서, 256k는 25만6000토큰을 뜻한다.
[마이크로소프트의 기기 측정](https://commandline.microsoft.com/local-models-sandboxed-tools-github-windows/)에 쓴 서피스 랩톱 울트라는 최대 128GB의 통합 메모리, 즉 CPU와 GPU가 공유하는 물리 메모리를 갖췄다. 첫 출하 모델은 문맥 길이 256k에서 최대 75.5GB를 썼다. 모델 파일은 53GB로 클라우드 고정밀 버전보다 80% 작았다.
작업 성공률 확인: 원 모델에서 기기 양자화 모델로 바꾸면 SWE-Bench Verified 점수는 72.6%에서 70.80%로, 터미널 작업 평가인 Terminal-Bench 2.1은 62.9%에서 66.29%로 변했다. 두 평가의 변화가 반대여서 용량 축소의 성능 영향을 한 방향으로 단정할 수 없다.
처리량 측정 조건은 2026년 10월 5일, 윈도 64비트 암 환경의 실행 런타임 llama.cpp·CUDA와 슬라이딩 윈도우 추측 디코딩이다. 64k에서 초당 923.5토큰을 기록했지만 본문은 입력 처리량, 시험 주석은 출력 생성 처리량이라고 적어 측정 종류가 불분명하다. 이 수치만으로 체감 응답성의 개선 폭을 판단하기는 어렵다.
실행 여유는 파일 크기만으로 판단할 수 없다. 운영체제와 개발 도구도 메모리를 쓰고, 추측 디코딩에는 추가 작업 메모리가 든다. 이전 토큰의 계산 상태를 저장하는 캐시 역시 문맥이 길어질수록 커진다.
3. 다중 모델 연구 결과는 로컬 배치 성능과 다르다
깃허브가 2026년 9월 4일 공개한 프로젝트 하이드라퓨전은 다중 모델 조율 연구 미리보기다. 모델 하나로 해결하거나, 초안이 기준에 못 미치면 더 강한 모델로 넘기거나, 다른 모델의 검토를 거쳐 수정하는 경로를 고른다. 10월 발표는 이를 로컬·클라우드로 확장하는 방향을 제시했다.
[하이드라퓨전의 오프라인 평가](https://github.blog/ai-and-ml/github-copilot/project-hydrafusion-frontier-quality-via-multi-model-orchestration/)에서 클로드 오퍼스 5 대비 터미널 과제의 추정 작업 비용은 67% 줄고, 정답으로 검증된 과제 비율은 4.9%포인트 올랐다.
비용은 초안·검토·수정·상위 모델 전환·재시도·대체 실행을 모두 합친 추정치다. 단일 모델 호출 가격이나 로컬 기기의 총운영비가 아니다.
평가 확인: TerminalBench 2.1, DeepSWE, CheckpointBench를 썼다. 마지막은 실제 코파일럿 세션을 바탕으로 만든 내부 평가이며, 연구팀은 세 평가 집합을 이용해 구성을 반복 조정했다. 결과는 모델이 답을 만들 때 쓰는 추론 설정을 같은 ‘중간’ 수준으로 맞추고 입력·도구·실행 제한·가격·채점 조건도 통일한 최적 구성의 수치다. 해당 평가판과 모델 구성에 묶인 결과이므로 기기 모델의 실사용 비용이나 속도와 직접 비교할 수 없다.
연구 미리보기는 첫 요청 한 번으로 맡길 수 있는 범위가 명확한 코딩 과제부터 시도하도록 권장한다. 긴 대화를 여러 차례 이어가는 성능은 다음 개선 대상이다.
명령줄 도구의 실험 기능을 켜는 명령이다.
/experimental on4. 샌드박스는 모델이 아니라 도구의 권한을 제한한다
도구 실행을 격리하는 [마이크로소프트 실행 컨테이너](https://blogs.windows.com/windowsdeveloper/2026/10/07/microsoft-execution-containers-policy-driven-containment-for-ai-agents/)는 10월 7일 정식 제공됐다. 개발자나 조직이 허용할 파일과 네트워크 목적지를 정하면 운영체제가 그 경계를 적용한다. 에이전트가 스스로 권한을 늘릴 수 없도록 외부에서 작업 구역을 정하는 방식이다.
코파일럿은 윈도에서 경량 프로세스 격리를 사용한다. 샌드박스를 켜면 셸 명령과 기본 설정의 로컬 도구 서버·언어 서버가 격리 대상이 된다.
[코파일럿의 격리 범위 설명](https://commandline.microsoft.com/local-models-sandboxed-tools-github-windows/)에 따르면 내장 파일 도구는 도우미 내부의 정책 검사 대상이지 운영체제가 격리한 자식 프로세스는 아니다. 원격 도구 서버도 로컬 샌드박스 밖에 있다.
로컬 추론은 세션 전체의 오프라인 동작을 뜻하지 않는다. 대시보드 예제도 외부 서비스의 이슈·변경 요청 정보를 쓰므로 오프라인 보장은 아니다.
5. 로컬 모델 직접 선택도 지원한다
직접 선택은 윈도 머신러닝 공급자나 오픈에이아이 호환 로컬 접속점을 통해 지원한다.
도입 판단에서는 모델 실행 위치와 과제 완수 능력, 도구별 권한 경계를 따로 확인해야 한다.