帮助 AI 模型进行 GPU 推理运算的 FlashInfer 于 2026年10月9日发布了新版本。将模型中负责运算的部分分配到多个 GPU 的选择有所增加,为在 Rubin 或 Blackwell 工作站上开发分布式推理的人员增添了可评估的执行路径。
1. 不是首次支持,而是扩展执行路径
混合专家(MoE)是一种针对每个输入选择模型中部分专家运算的结构。它类似于只挑选所需成员来分配工作的团队。专家并行是将这些专家分布到多个 GPU 的方式,而量化是减少数值表示位数的方法。
工作站的 W4A16 运算在 v0.6.14 中就已存在。这种方式以 4 位处理权重,以 16 位处理中间计算使用的激活值。
上一版 v0.7.0 也已具备工作站的 MXFP8 专家并行路径。此次变化并非首次引入量化专家分布式执行,而是扩展支持的格式和执行路径。
2. Rubin 需确认支持格式和合并方式
Rubin 新增了 NVFP4 和 MXFP8 专家的分布式执行路径。专家结果的合并与最终输出使用 16 位格式。
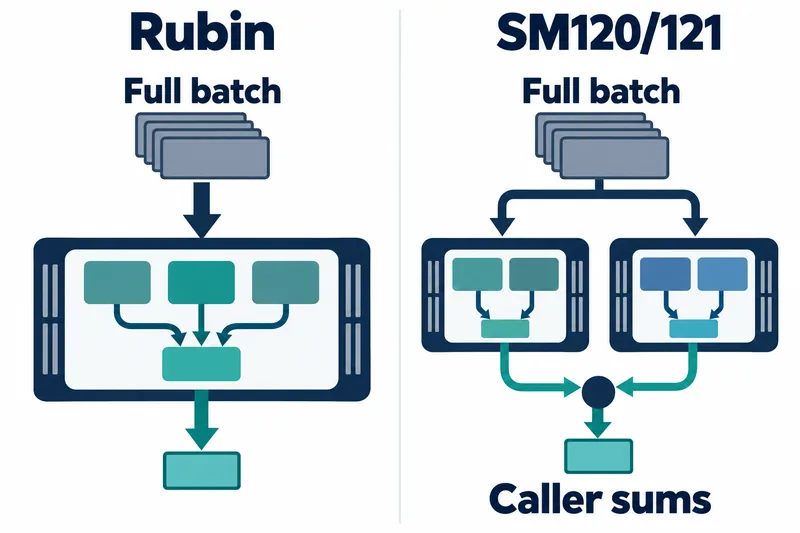
集成时需确认的入口是 MoEEpLayer,合并与输出格式为 BF16。变更提案说明,内核内部求和默认关闭,因为多个运算更新同一数值的顺序可能不固定。
3. 工作站由调用方负责通信
Blackwell 工作站的目标是 SM120 和 SM121。这条路径在前述权重 4 位、激活值 16 位运算的基础上增加了专家分布式执行。
各 GPU 的专家部署通过可选参数 expert_map 指定。每个 GPU 接收完整输入批次,仅计算自身持有的专家,各 GPU 的执行进程之间不交换词元。词元是模型处理的文本片段。
其优势在于可以将专家分配到各张卡上计算。但将完整输入传给每个 GPU 并合并部分输出的责任,仍由发起调用的上层程序承担。因此,评估集成成本时,不仅要考虑专家计算,还要考虑输入传递与输出求和。
支持限制也因实现而异。该变更提案中独立的 B12x NVFP4 实现按模型全局专家编号查找各专家的存储空间,因此仍拒绝专家并行。
发布说明另行介绍的、基于 CuTe DSL 的新 NVFP4 运算实现共享预先准备的专家权重布局。使用单份权重副本时,首次处理输入上下文可选择 4 位激活值,逐个生成词元时可选择 16 位激活值。未说明这些新实现是否支持专家并行。
4. 1.36 倍是单层运算的比较
性能数据的测量设备为 DGX Spark,模型为 Qwen3.8-Flash-Next。测试以单个词元运行该模型的一个 MoE 层。
发布说明称,在此条件下,W4A16 实现的速度是 Marlin 的 1.36 倍。由于未提供完整测量方法和专家并行配置,没有依据将其解读为 Rubin 或整个多 GPU 服务的加速比。
正确性检查与速度比较是两回事。工作站变更提案报告称,两台 RTX Pro 6000 的结果与运行全部专家的单 GPU 结果一致。
Rubin 变更提案也报告,在使用相同执行代码的另一代码版本中,单 GPU 和四进程专家并行检查均已通过。两份变更提案均未给出数值化的速度结果。
此次扩展的价值在于增加了量化专家的部署选择,是否采用应以拟使用实现的支持范围和完整执行路径为依据。