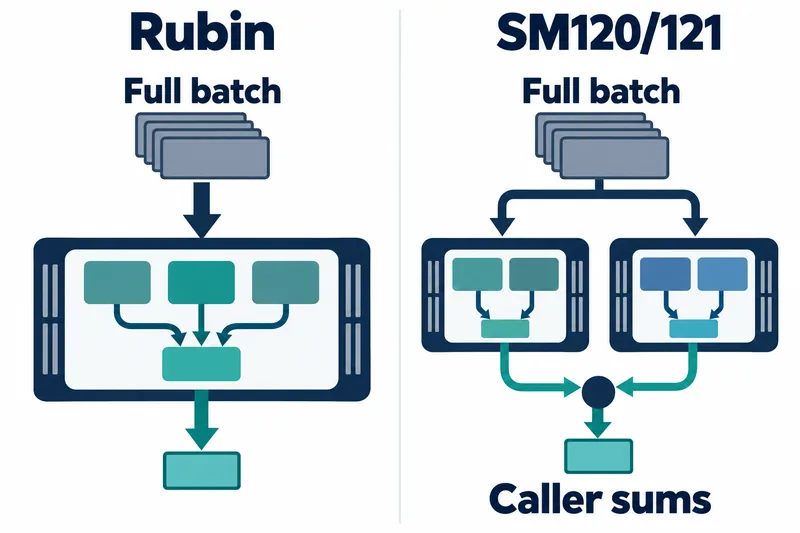
AI 모델의 GPU 추론 연산을 돕는 FlashInfer가 2026년 10월 9일 새 버전을 공개했다. 모델의 연산 담당 부분을 여러 GPU에 나눌 선택지가 늘어, Rubin이나 Blackwell 워크스테이션에서 분산 추론을 개발하는 이들이 검토할 실행 경로가 추가됐다.
1. 첫 지원이 아니라 실행 경로의 확대다
전문가 혼합(MoE)은 입력마다 모델 안의 일부 전문가 연산을 골라 쓰는 구조다. 필요한 담당자만 골라 일을 맡기는 팀과 비슷하다. 전문가 병렬화는 이 전문가들을 여러 GPU에 나눠 두는 방식이며, 양자화는 수치 표현의 비트 수를 줄이는 방법이다.
워크스테이션용 W4A16 연산 자체는 v0.6.14에 이미 있었다. 이는 가중치를 4비트, 중간 계산에 쓰는 활성값을 16비트로 다루는 방식이다.
직전 v0.7.0에도 워크스테이션용 MXFP8 전문가 병렬 경로가 있었다. 이번 변화는 양자화 전문가 분산의 첫 도입이 아니라, 지원 형식과 실행 경로의 확대다.
2. Rubin은 지원 형식과 결합 방식을 확인한다
Rubin에는 NVFP4와 MXFP8 전문가의 분산 실행 경로가 추가됐다. 전문가 결과의 결합과 최종 출력에는 16비트 형식을 쓴다.
통합 시 확인할 진입점은 MoEEpLayer이며, 결합·출력 형식은 BF16이다. 커널 내부 합산은 여러 연산이 같은 값을 갱신하는 순서가 일정하지 않을 수 있어 기본적으로 꺼져 있다고 변경 제안은 설명한다.
3. 워크스테이션은 호출자가 통신을 맡는다
Blackwell 워크스테이션의 대상은 SM120과 SM121이다. 이 경로는 앞서 설명한 가중치 4비트·활성값 16비트 연산에 전문가 분산을 추가한다.
GPU별 전문가 배치는 선택 인자인 expert_map으로 지정한다. 각 GPU는 전체 입력 묶음을 받아 자신이 가진 전문가만 계산하며, GPU별 실행 프로세스 사이에서 토큰을 교환하지 않는다. 토큰은 모델이 처리하는 텍스트 조각이다.
이익은 전문가를 카드별로 나눠 계산할 수 있다는 점이다. 대신 전체 입력을 각 GPU에 전달하고 부분 출력을 합치는 책임은 호출하는 상위 프로그램에 남는다. 따라서 통합 비용은 전문가 계산만이 아니라 입력 전달과 출력 합산까지 포함해 판단해야 한다.
지원 제한도 구현별로 다르다. 이 변경 제안의 별도 B12x NVFP4 구현은 모델 전체 기준의 전문가 번호로 각 전문가의 저장 공간을 찾는 구조여서 전문가 병렬화를 계속 거부한다.
릴리스가 별도로 소개한 CuTe DSL 기반의 새 NVFP4 연산 구현들은 준비한 전문가 가중치 배치를 공유한다. 단일 가중치 사본으로 입력 문맥을 처음 처리할 때는 4비트 활성값을, 토큰을 하나씩 생성할 때는 16비트 활성값을 선택할 수 있다. 이 새 구현들의 전문가 병렬화 지원 여부는 제시되지 않았다.
4. 1.36배는 한 계층의 연산 비교다
성능 수치의 측정 장비는 DGX Spark이고 모델은 Qwen3.8-Flash-Next다. 이 모델의 MoE 한 계층을 단일 토큰으로 실행했다.
릴리스는 이 조건에서 W4A16 구현이 Marlin 대비 1.36배 빠르다고 설명한다. 전체 측정 방법과 전문가 병렬 구성이 제시되지 않았으므로, 이를 Rubin이나 다중 GPU 서비스 전체의 가속률로 해석할 근거는 없다.
정확성 검사는 속도 비교와 별개다. 워크스테이션 변경 제안은 RTX Pro 6000 두 대의 결과가 전체 전문가를 실행한 단일 GPU 결과와 일치했다고 보고했다.
Rubin 변경 제안도 같은 실행 코드를 쓰는 별도 코드 버전에서 단일 GPU와 네 프로세스의 전문가 병렬 검사 통과를 보고했다. 두 변경 제안에는 수치로 된 속도 결과가 제시되지 않았다.
이번 확대의 가치는 양자화 전문가의 배치 선택지가 늘었다는 데 있으며, 도입 판단은 사용하려는 구현의 지원 범위와 전체 실행 경로를 기준으로 해야 한다.