AIモデルのGPU推論演算を支援するFlashInferが、2026年10月9日に新バージョンを公開した。モデルの演算を担う部分を複数のGPUに分ける選択肢が増え、RubinやBlackwellワークステーションで分散推論を開発する人が検討できる実行経路が追加された。
1. 初対応ではなく実行経路の拡大
混合エキスパート(MoE)は、入力ごとにモデル内の一部のエキスパート演算を選んで使う構造だ。必要な担当者だけを選んで仕事を任せるチームに似ている。エキスパート並列化はこれらを複数のGPUに分けて配置する方式で、量子化は数値表現のビット数を減らす方法だ。
ワークステーション向けW4A16演算自体は、v0.6.14にすでに存在していた。重みを4ビット、中間計算に使う活性値を16ビットで扱う方式だ。
直前のv0.7.0にも、ワークステーション向けMXFP8エキスパート並列経路があった。今回の変更は量子化エキスパートの分散の初導入ではなく、対応形式と実行経路の拡大だ。
2. Rubinは対応形式と結合方式を確認
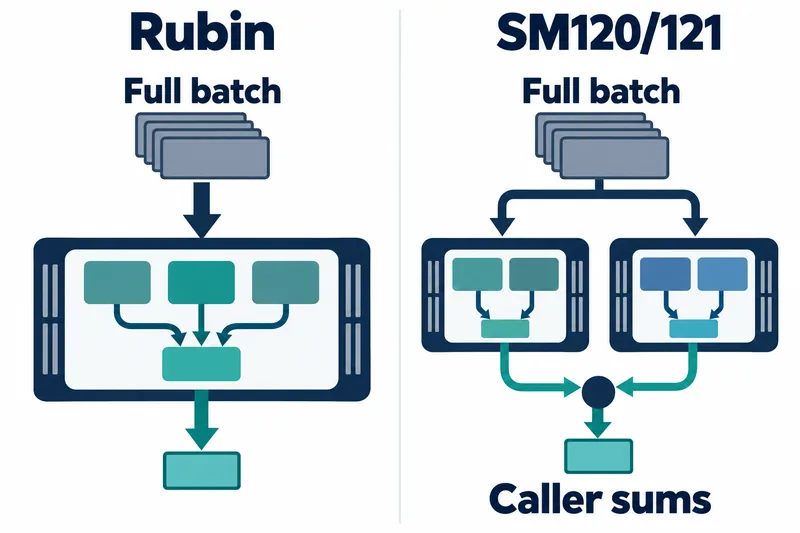
Rubinには、NVFP4とMXFP8エキスパートの分散実行経路が追加された。エキスパートの結果の結合と最終出力には16ビット形式を使う。
統合時に確認するエントリーポイントはMoEEpLayerで、結合・出力形式はBF16だ。変更提案によると、カーネル内部の合算は、複数の演算が同じ値を更新する順序が一定にならない可能性があるため、デフォルトで無効になっている。
3. ワークステーションは呼び出し側が通信を担当
Blackwellワークステーションでの対象はSM120とSM121だ。この経路は、前述の重み4ビット・活性値16ビットの演算にエキスパートの分散を追加する。
GPUごとのエキスパート配置は、オプション引数expert_mapで指定する。各GPUは入力バッチ全体を受け取り、自身が持つエキスパートだけを計算し、GPUごとの実行プロセス間ではトークンを交換しない。トークンはモデルが処理するテキストの断片だ。
利点は、エキスパートをカードごとに分けて計算できる点だ。一方、入力全体を各GPUに配布し、部分出力を合算する責任は呼び出し元の上位プログラムに残る。そのため統合コストは、エキスパートの計算だけでなく、入力の配布と出力の合算まで含めて判断する必要がある。
対応上の制約も実装によって異なる。この変更提案の別のB12x NVFP4実装は、モデル全体を基準とするエキスパート番号で各エキスパートの保存領域を探す構造のため、引き続きエキスパート並列化を受け付けない。
リリースで別途紹介されたCuTe DSLベースの新しいNVFP4演算実装群は、準備したエキスパートの重み配置を共有する。単一の重みコピーで、入力コンテキストを最初に処理する際は4ビット活性値を、トークンを1つずつ生成する際は16ビット活性値を選べる。これらの新実装がエキスパート並列化に対応するかは示されていない。
4. 1.36倍は1層の演算比較
性能値の測定機器はDGX Sparkで、モデルはQwen3.8-Flash-Nextだ。このモデルのMoEの1層を単一トークンで実行した。
リリースによると、この条件でW4A16実装はMarlin比で1.36倍高速だ。測定方法の全容とエキスパート並列構成が示されていないため、これをRubinや複数GPUのサービス全体の高速化率と解釈する根拠はない。
正確性の検証は速度比較とは別だ。ワークステーションの変更提案では、RTX Pro 6000を2台使った結果が、全エキスパートを実行した単一GPUの結果と一致したと報告された。
Rubinの変更提案も、同じ実行コードを使う別のコードバージョンで、単一GPUと4プロセスのエキスパート並列検証に合格したと報告した。両変更提案には、数値による速度の結果は示されていない。
今回の拡充の価値は、量子化エキスパートの配置の選択肢が増えた点にあり、導入は使いたい実装の対応範囲と実行経路全体を基準に判断すべきだ。