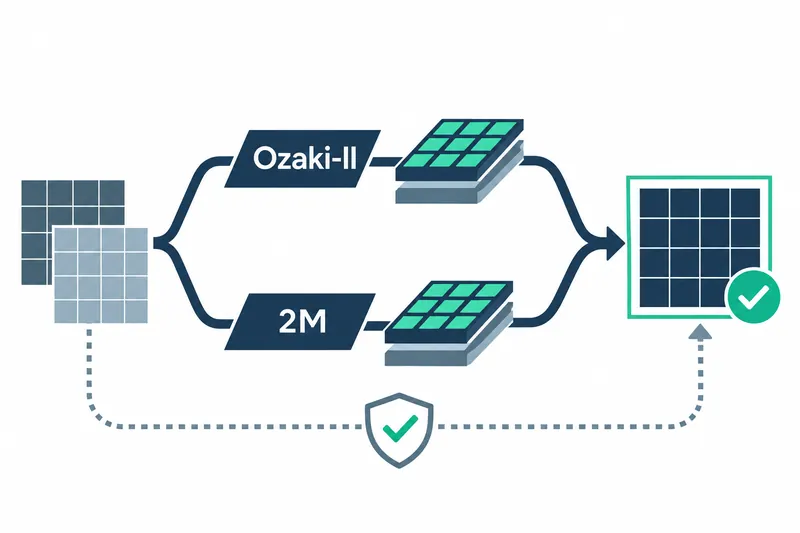
NVIDIA 为 cuBLAS 添加了新算法,在保持精度的同时加速实数和复数矩阵乘法。分子与材料模拟开发者无需修改现有应用代码,即可利用 GPU 的高速运算单元缩短计算时间。
1. 保持精度并切换运算路径
CUDA Toolkit 13.4.2 中的 cuBLAS 将双精度(FP64)输入转换为整数分片,在 GPU 的矩阵运算单元 Tensor Core 上相乘,再还原结果。自动动态精度功能会在运行时判断承载有效数字的尾数需要多少位。
库会根据性能选择 Ozaki-I 或 Ozaki-II。当所需尾数位数超过默认值或用户指定的上限时,会切换至 GPU 的原生 FP64 运算路径,以保持准确性。
在实数矩阵乘法 DGEMM 中,Ozaki-II 对量化后的操作数按一组较小且两两互质的整数取模,对各模数对应的余数执行整数矩阵乘法,再重建精确乘积。相比多次对分片进行乘法的 Ozaki-I,它所需的运算次数更少。据 NVIDIA 介绍,在达到与 FP64 相同的准确性时,Ozaki-I 所需的 Tensor Core 矩阵乘法次数约为 Ozaki-II 的两倍。
2. 复数运算将乘法次数减至两次
复数矩阵乘法 ZGEMM 传统上需要四次同等大小的实数矩阵乘法。以两次乘法计算复数乘积的 2M 方法,利用 Ozaki-II 的精确整数运算将其减至两次。中间的加减法也通过整数精确执行。
NVIDIA 表示,从 CUDA Toolkit 13.4 起已采用此方法。以下是原文用于解释传统复数乘法的公式,可看出组合实部和虚部所需的四次乘法。
A = Ar + i(Ai); B = Br + i(Bi)

C = A x B = (Ar·Br − Ai·Bi) + i(Ar·Bi + Ai·Br)
3. 公布各 GPU 的最高加速倍数与吞吐量
据公司公布的数据,采用 Ozaki-II 的 DGEMM 相比 GPU 原生 FP64 运算,在 VR NVL72 上最高达到 5.5 倍速度,在 GB200 上最高为 3.9 倍,在 RTX PRO 6000 Blackwell Server Edition 上最高为 23 倍,即使在所测的最小矩阵上也达到 10 倍。
在 GB200 上,矩阵越大,加速效果越明显。据公司公布的数据,DGEMM 的最高吞吐量在 VR NVL72 上为 175 TFLOPS,在 GB200 上为 147 TFLOPS,在 RTX PRO 6000 上为 37 TFLOPS。这些分别是不同设备上的峰值吞吐量。
4. 分子与材料计算的运行时间也有所缩短
计算电子相互作用的量子化学方法 CCSD 用于计算电子相关,其案例在单个 GPU 上处理了 S22 数据库中的五个分子复合物。据公司公布的数据,相比原生 FP64,整体运行速度在 VR NVL72 上为 2 倍,在 GB200 上为 1.4 倍;在将尾数固定为 32 位、结合不同数值精度的混合精度模式下,分别为 5 倍和 3.5 倍。
实验采用了在计算中固定原子内层电子的冻结核方法,以及用数学形式表示电子状态的 cc-pVTZ 基组。据公司公布的数据,在 FP64 精度设置下,电子相互作用产生的相关能误差小于 10⁻¹⁴ Eh。Eh 是能量单位哈特里。
同一研究中的尿嘧啶二聚体计算同时公布了整体运行与单次矩阵乘法的吞吐量。公司公布的以下数据表明,即便在同一问题中,整体任务与核心运算的吞吐量也存在差异。
表:尿嘧啶二聚体计算的吞吐量
条件:单个 Rubin GPU,CUDA Toolkit 13.4.2 中的 cuBLAS,冻结核 CCSD/cc-pVTZ,Ozaki-II 尾数固定为 32 位
单位:TFLOPS
| 测量范围 | 吞吐量 |
|---|---|
| 整体运行 | 173 |
| 单次矩阵乘法峰值 | 368 |
| 单次矩阵乘法平均值 | 200 |
在这项尾数为 32 位的计算中,结合核心运算峰值与整体运行吞吐量,更容易了解实际任务的加速效果。
材料科学代码 BerkeleyGW 的 Epsilon 模块在 32 个 GPU 上运行了 Si998 基准问题。据公司公布的数据,采用 53 位尾数的新方法相比各设备的原生 ZGEMM,在 GB200 上达到 3.9 倍速度,在 VR NVL72 上达到 6.6 倍;将 Blackwell 原生运算与 VR NVL72 的新方法相比,整体运行速度提升至 5.8 倍。
NVIDIA 表示,自动精度和 53 位尾数设置下的矩阵元素,与基准运算相比均在小数点后 10 位保持一致。
5. 使用最新工具验证实际任务的速度与准确性
利用整数 Tensor Core 高吞吐量的好处在于兼顾 FP64 准确性与速度。但整数分解、还原和中间值存储会消耗计算与内存资源,GB200 上的小矩阵没有收益,因此选择了原生 FP64 路径。CCSD 案例报告的 32 位混合精度能量误差小于 10⁻¹⁰ Eh,因此选择更快计算时,也需考察容许误差。
如需应用,可安装最新 CUDA Toolkit,并查阅 cuBLAS 的浮点仿真文档与官方示例。策略设置函数为 cublasSetEmulationStrategy(),文档也介绍了直接控制尾数位数的方法。
Ozaki-II 与 2M 是 cuBLAS 的实用扩展,旨在自动反映精度需求,并利用 Tensor Core 性能缓解 FP64 矩阵乘法的瓶颈。