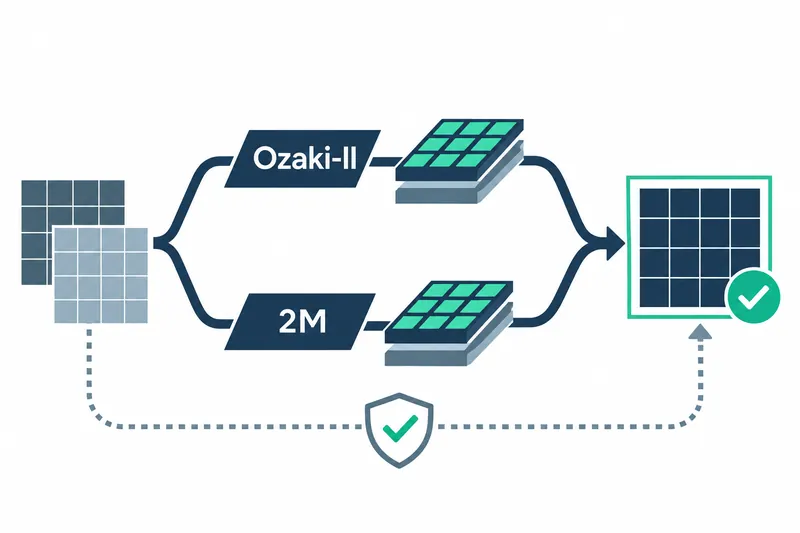
NVIDIAがcuBLASに、精度を維持しながら実数・複素数行列乗算を高速化する新アルゴリズムを追加した。分子・材料シミュレーションの開発者は、既存のアプリケーションコードを変更せずにGPUの高速演算装置を活用し、計算時間を短縮できる。
1. 精度を維持しながら演算経路を切り替える
CUDA Toolkit 13.4.2のcuBLASは、倍精度(FP64)入力を整数の断片に変換し、GPUの行列演算装置であるTensor Coreで乗算した後、結果を復元する。自動動的精度機能は、有効数字を格納する仮数ビットがどれだけ必要かを実行中に判断する。
ライブラリは性能を考慮してOzaki-IとOzaki-IIのいずれかを選ぶ。必要な仮数ビット数が既定値やユーザー指定の上限を超えると、GPUのネイティブFP64演算経路に切り替えて精度を維持する。
実数行列乗算のDGEMMでは、Ozaki-IIは大きな整数を小さな数で割った余り同士を乗算し、結果を復元する。断片同士を何度も乗算するOzaki-Iより演算数が少ない。NVIDIAの説明によると、FP64と同じ精度を得るには、Ozaki-IはOzaki-IIの約2倍のTensor Core行列乗算を必要とする。
2. 複素数演算では乗算を2回に減らす
複素数行列乗算のZGEMMは、従来、同じサイズの実数行列乗算を4回使う。2回の乗算で複素数の積を計算する2M方式は、Ozaki-IIの正確な整数演算を活用してこれを2回に減らす。途中の加算と減算も整数で正確に実行する。
NVIDIAはCUDA Toolkit 13.4からこの方式を使用していると述べた。以下は原文が従来の複素数乗算を説明する数式で、実部と虚部を組み合わせる4回の乗算が示されている。
A = Ar + i(Ai); B = Br + i(Bi)

C = A x B = (Ar·Br − Ai·Bi) + i(Ar·Bi + Ai·Br)
3. GPU別の最大高速化率とスループットを公開
同社の発表によると、Ozaki-IIを適用したDGEMMはGPUのネイティブFP64演算に比べ、VR NVL72で最大5.5倍、GB200で最大3.9倍高速だった。RTX PRO 6000 Blackwell Server Editionでは最大23倍、測定した最小の行列でも10倍高速だった。
GB200では行列が大きくなるほど高速化の効果が高まった。同社発表の最大DGEMMスループットは、VR NVL72で175 TFLOPS、GB200で147 TFLOPS、RTX PRO 6000で37 TFLOPSだった。それぞれ異なる機器で得られた最高スループットだ。
4. 分子・材料計算でも実行時間を短縮
電子間の相互作用である電子相関を計算する量子化学手法CCSDの事例では、S22データベースの5つの分子複合体を単一GPUで処理した。同社発表では、ネイティブFP64に対する全体の実行速度はVR NVL72で2倍、GB200で1.4倍だった。仮数を32ビットに固定し、異なる数値精度を併用する混合精度では、それぞれ5倍と3.5倍だった。
実験では、原子の内側の電子を計算上固定する凍結内殻法と、電子状態を数学的に表現するcc-pVTZ基底関数を用いた。同社発表では、FP64精度設定での電子間相互作用による相関エネルギーの誤差は10⁻¹⁴ Eh未満だった。Ehはエネルギー単位のハートリーだ。
同じ研究のウラシル二量体計算では、実行全体と個別の行列乗算のスループットを併せて公開した。同社発表の以下の数値は、1つの問題でも処理全体と中核演算のスループットに差があることを示している。
表:ウラシル二量体計算のスループット
条件:Rubin単一GPU、CUDA Toolkit 13.4.2のcuBLAS、凍結内殻CCSD/cc-pVTZ、Ozaki-IIの仮数を32ビットに固定
単位:TFLOPS
| 測定範囲 | スループット |
|---|---|
| 実行全体 | 173 |
| 個別行列乗算の最高値 | 368 |
| 個別行列乗算の平均値 | 200 |
仮数32ビットのこの計算では、中核演算の最高値と実行全体のスループットを併せて見ると、実際の処理の高速化効果を把握しやすい。
材料科学コードBerkeleyGWのEpsilonモジュールは、Si998ベンチマークを32基のGPUで実行した。同社発表では、仮数53ビットの新方式は各機器のネイティブZGEMMよりGB200で3.9倍、VR NVL72で6.6倍高速だった。Blackwellのネイティブ演算とVR NVL72の新方式を比較した全体の実行速度向上は5.8倍だった。
自動精度と仮数53ビット設定のどちらも、基準の演算と比較して行列要素が小数点以下10桁まで一致したとNVIDIAは述べた。
5. 最新ツールで実際の処理の速度と精度を確認する
整数Tensor Coreの高いスループットを活用する利点は、FP64の精度と速度を両立できる点だ。一方、整数への分解・復元と中間値の保存には計算とメモリのコストがかかり、GB200の小さな行列では利点がなく、ネイティブFP64経路が選択された。CCSD事例の32ビット混合精度ではエネルギー誤差が10⁻¹⁰ Eh未満と報告されており、より速い計算を選ぶ際は許容誤差も確認すべきだ。
適用するには、最新のCUDA Toolkitをインストールし、cuBLASの浮動小数点エミュレーション文書と公式サンプルを確認すればよい。戦略設定関数はcublasSetEmulationStrategy()で、文書では仮数ビットを直接制御する方法も案内している。
Ozaki-IIと2Mは、精度要件を自動で反映しながら、FP64行列乗算のボトルネックをTensor Coreの性能で緩和しようとする、cuBLASの実用的な拡張だ。