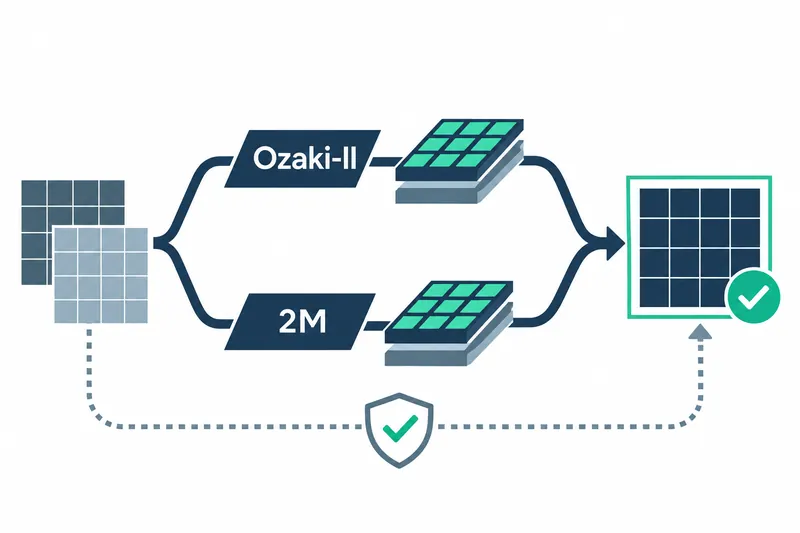
NVIDIA가 cuBLAS에 정밀도를 유지하면서 실수·복소수 행렬 곱셈을 가속하는 새 알고리즘을 추가했다. 분자·재료 시뮬레이션 개발자는 기존 애플리케이션 코드를 바꾸지 않고도 GPU의 고속 연산 장치를 활용해 계산 시간을 줄일 수 있다.
1. 정밀도를 유지하며 연산 경로를 바꾼다
CUDA Toolkit 13.4.2의 cuBLAS는 이중정밀도(FP64) 입력을 정수 조각으로 바꿔 GPU의 행렬 연산 장치인 Tensor Core에서 곱한 뒤 결과를 복원한다. 자동 동적 정밀도 기능은 유효 숫자를 담는 가수 비트가 얼마나 필요한지 실행 중 판단한다.
라이브러리는 성능을 고려해 Ozaki-I와 Ozaki-II 중 하나를 고른다. 필요한 가수 비트가 기본값이나 사용자가 지정한 상한을 넘으면 GPU의 기본 FP64 연산 경로로 전환해 정확도를 유지한다.
실수 행렬 곱셈인 DGEMM에서 Ozaki-II는 큰 정수를 작은 수로 나눈 나머지들을 곱하고 결과를 복원한다. 조각끼리 여러 번 곱하는 Ozaki-I보다 연산 수가 적다. NVIDIA 설명에 따르면 FP64와 같은 정확도를 맞출 때 Ozaki-I에는 Ozaki-II보다 대략 두 배의 Tensor Core 행렬 곱셈이 필요하다.
2. 복소수 연산은 곱셈을 두 번으로 줄인다
복소수 행렬 곱셈인 ZGEMM은 전통적으로 같은 크기의 실수 행렬 곱셈 네 번을 쓴다. 곱셈 두 번으로 복소수 곱을 계산하는 2M 방식은 Ozaki-II의 정확한 정수 연산을 활용해 이를 두 번으로 줄인다. 중간 덧셈과 뺄셈도 정수로 정확하게 수행한다.
NVIDIA는 CUDA Toolkit 13.4부터 이 방식을 사용한다고 밝혔다. 아래는 원문이 기존 복소수 곱셈을 설명하는 수식으로, 실수부와 허수부를 조합하는 네 번의 곱셈이 드러난다.
A = Ar + i(Ai); B = Br + i(Bi)

C = A x B = (Ar·Br − Ai·Bi) + i(Ar·Bi + Ai·Br)
3. GPU별 최대 가속과 처리량을 공개했다
회사 발표 기준, Ozaki-II를 적용한 DGEMM은 GPU 기본 FP64 연산보다 VR NVL72에서 최대 5.5배, GB200에서 최대 3.9배 빨랐고, RTX PRO 6000 Blackwell Server Edition에서는 최대 23배, 가장 작은 측정 행렬에서도 10배 빨랐다.
GB200에서는 행렬이 커지면서 가속 효과가 커졌다. 회사 발표 기준 최대 DGEMM 처리량은 VR NVL72에서 175 TFLOPS, GB200에서 147 TFLOPS, RTX PRO 6000에서 37 TFLOPS였다. 각각 다른 장비에서 얻은 최고 처리량이다.
4. 분자와 재료 계산에서도 실행 시간을 줄였다
전자들의 상호작용을 계산하는 양자화학 기법 전자 상관을 계산하는 CCSD 사례는 S22 데이터베이스의 분자 복합체 다섯 개를 단일 GPU에서 처리했다. 회사 발표 기준, 기본 FP64 대비 전체 실행 속도는 VR NVL72에서 2배, GB200에서 1.4배였고, 가수 비트를 32개로 고정한 서로 다른 숫자 정밀도를 함께 쓰는 혼합 정밀도에서는 각각 5배와 3.5배였다.
실험은 원자 안쪽 전자를 계산에서 고정하는 동결핵 방식과 전자 상태를 수학적으로 표현하는 cc-pVTZ 기저 함수를 썼다. 회사 발표 기준 FP64 정밀도 설정에서 전자 상호작용에 따른 상관 에너지의 오차는 10⁻¹⁴ Eh 미만이었다. Eh는 에너지 단위인 하트리다.
같은 연구의 우라실 이합체 계산에서는 전체 실행과 개별 행렬 곱셈의 처리량을 함께 공개했다. 회사 발표 기준, 아래 수치는 하나의 문제에서도 전체 작업과 핵심 연산의 처리량에 차이가 있음을 보여 준다.
표: 우라실 이합체 계산의 처리량
조건: Rubin 단일 GPU, CUDA Toolkit 13.4.2의 cuBLAS, 동결핵 CCSD/cc-pVTZ, Ozaki-II 가수 32비트 고정
단위: TFLOPS
| 측정 범위 | 처리량 |
|---|---|
| 전체 실행 | 173 |
| 개별 행렬 곱셈 최고 | 368 |
| 개별 행렬 곱셈 평균 | 200 |
가수 32비트의 이 계산에서는 핵심 연산의 최고치와 전체 실행 처리량을 함께 볼 때 실제 작업의 가속 효과를 파악하기 쉽다.
재료 과학 코드 BerkeleyGW의 Epsilon 모듈은 Si998 기준 문제를 32개 GPU에서 실행했다. 회사 발표 기준, 가수 53비트의 새 방식은 각 장비의 기본 ZGEMM보다 GB200에서 3.9배, VR NVL72에서 6.6배 빨랐고, Blackwell의 기본 연산과 VR NVL72의 새 방식을 비교한 전체 실행 속도 향상은 5.8배였다.
자동 정밀도와 가수 53비트 설정 모두 기준 연산과 비교해 행렬 원소가 소수점 아래 10자리까지 같았다고 NVIDIA는 밝혔다.
5. 최신 도구로 실제 작업의 속도와 정확도를 확인한다
정수 Tensor Core의 높은 처리량을 활용하는 이익은 FP64 정확도와 속도를 함께 노릴 수 있다는 점이다. 반면 정수 분해·복원과 중간값 저장에 계산·메모리가 들고, GB200의 작은 행렬에서는 이득이 없어 기본 FP64 경로가 선택됐다. CCSD 사례의 32비트 혼합 정밀도에서는 에너지 오차가 10⁻¹⁰ Eh 미만으로 보고돼, 더 빠른 계산을 택할 때 허용 오차도 함께 살펴야 한다.
적용하려면 최신 CUDA Toolkit을 설치하고 cuBLAS의 부동소수점 에뮬레이션 문서와 공식 샘플을 살펴보면 된다. 전략 설정 함수는 cublasSetEmulationStrategy()이며, 문서는 가수 비트를 직접 제어하는 방법도 안내한다.
Ozaki-II와 2M은 정밀도 요구를 자동으로 반영하면서 FP64 행렬 곱셈의 병목을 Tensor Core 성능으로 완화하려는 cuBLAS의 실용적 확장이다.