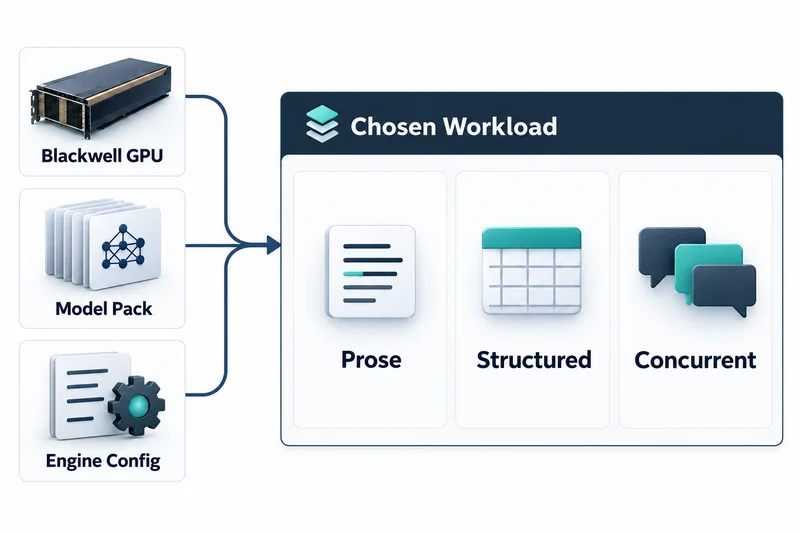
Basalt 开发者在10月10日的 r/LocalLLaMA 帖子中报告,Qwen3.8-Flash-Next 的解码速度为结构化输出 665 tok/s、散文 354 tok/s。
这是开发者本人的测量。本文未能重新打开帖子正文,只沿用了帖子标题中的两个数字。
在同一引擎中,仅改变任务类型,吞吐量就相差近一倍。因此很难把单个数字理解为对交互式工作的普遍承诺。
绑定 Blackwell sm_120 与 CUDA 13 的部署边界
根据 README,Basalt 是从 Strata 分叉、收窄到 Qwen3.8-Flash-Next 的本地推理引擎。它要求带 AVX2 的 Linux x86-64、计算能力 12.0 的 NVIDIA Blackwell GPU 以及 CUDA 13。
放不进显存的专家(expert,即 MoE 的子网络)放在系统内存中,也可选用第二块 GPU 作为对等专家层。
目标狭窄便于集中实现。但其他 GPU 世代或操作系统,并不会因为能运行别的 CUDA 推理软件就被涵盖。
模型文件中不包含的引擎设置
README 称引擎内置默认值未经调优:4096 上下文、fp16 KV、无推测解码、无专家缓存,而且模型文件不携带引擎参数。
设置集中写入一个 basalt_config.json,通过 --config 传入;优先级依次为命令行、配置文件、内置默认值。
因此,只下载模型包并以默认值启动,无法重现调优结果背后的条件。
--parallel 槽位与 KV 缓存分配
--parallel N 在引擎批处理槽位中同时处理 1 到 8 个请求,--max-context 由各槽位分摊。--parallel 4 --max-context 262144 时,每个槽位为 65536 个 Token。
使用 --slot-full-context 时,每个槽位都获得完整的 --max-context,但 KV 缓存变为 N 倍。槽位的 KV 缓存从专家缓存中划出。
提高并发,就要以每个请求的上下文或留给专家的内存为代价。
精度文档覆盖的测试范围
精度文档的测试配置是一块功率上限 400 W 的 RTX 5090,加上一块作为对等专家层的 RTX 5060 Ti。400 W 并不是两块 GPU 的合计功耗。
在固定专家层的情况下,275 个贪心提示无论是否使用 MTP 都生成了相同的 Token。提示长度为 19 到 395 个 Token,新生成 256 个 Token,文档自己说明这测试的是解码路径,而非长上下文。
文档还指出,专家在 CPU 与 GPU 之间移动时舍入可能不同。质量以 llama.cpp Q8_0 为参照,并以 100 块而非 20 块的结果作为比较依据。
这些都是项目自己的测试,不能保证每个编程或推理任务都有相同结果。
质量验收与内存布局是两项不同的测试
这些条件可分为两个验收问题:所选配置在目标任务和提示长度下能否给出可接受的答案,以及其内存布局在预期用户数下能否满足所需延迟。
短小的确定性一致性测试有助于跟踪实现变更,但不能替代面向工作负载的检查。多请求的总吞吐量提高,也不意味着单个请求更快完成。
在可见实际配置与槽位内存的条件下运行
在 Blackwell 工作站上试验时,可以把模型包版本、引擎构建和配置文件作为一组保存,并分别测量散文、结构化输出和并发服务。README 记录的启动与指标检查形式如下。
bin/basalt serve --config basalt_config.json --parallel 4 --max-context 262144
curl http://127.0.0.1:8080/metrics
据 README,服务器启动时会为每个设备输出一行 [server] kv cache:,槽位过多占用专家缓存时会发出警告。/metrics 在 live.slots 下报告 total、active 和 queue_depth。
对于依赖长对话历史的工作负载,直接用这些历史评估,比从短提示一致性结果外推更现实。本文没有运行 Basalt。
Basalt 的吞吐量数字,更准确的读法是模型包、配置文件与槽位内存布局共同作用的结果,而非引擎的裸速度。