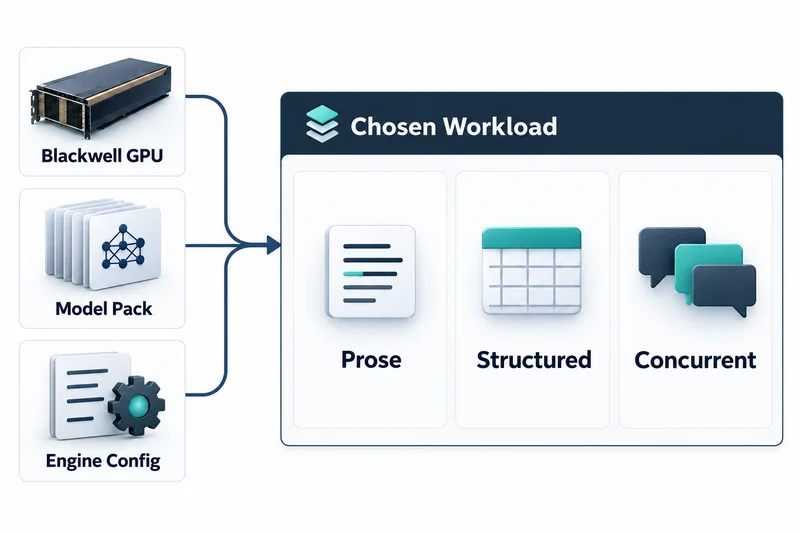
Basalt 개발자가 10월 10일 r/LocalLLaMA 게시물에서 Qwen3.8-Flash-Next 디코드 속도로 구조화 출력 665 tok/s, 산문 354 tok/s를 보고했다.
개발자 본인의 측정이다. 이 글은 게시물 본문을 다시 열람하지 못해 게시물 제목에 담긴 두 수치만 옮겼다.
같은 엔진에서 작업 종류만 바뀌어도 처리량이 두 배 가까이 갈린다. 숫자 하나를 대화형 작업 전반의 약속으로 읽기 어려운 이유다.
Blackwell sm_120과 CUDA 13에 묶인 배포 경계
README 기준 Basalt는 Strata를 포크해 Qwen3.8-Flash-Next 하나로 좁힌 로컬 추론 엔진이다. 요구 조건은 AVX2가 있는 Linux x86-64, compute capability 12.0의 NVIDIA Blackwell GPU, CUDA 13이다.
VRAM에 들어가지 않는 전문가(expert, MoE의 하위 네트워크)는 시스템 RAM에 두고, 선택적으로 두 번째 GPU를 피어 전문가 계층으로 쓴다.
대상이 좁은 만큼 구현을 집중할 수 있다. 다만 다른 GPU 세대나 운영체제는 다른 CUDA 추론 소프트웨어가 돈다는 이유만으로 포함되지 않는다.
모델 파일에 들어 있지 않은 엔진 설정
README는 엔진 내장 기본값이 튜닝되지 않은 상태라고 적었다. 4096 컨텍스트, fp16 KV, 투기적 디코딩 없음, 전문가 캐시 없음이며 모델 파일에는 엔진 플래그가 없다.
설정은 basalt_config.json 하나에 모아 --config로 넘기고, 우선순위는 명령줄, 설정 파일, 내장 기본값 순이다.
모델 팩만 받아 기본값으로 띄우면 튜닝된 결과의 조건이 재현되지 않는 구조다.
--parallel 슬롯과 KV 캐시 할당
--parallel N은 1~8개 요청을 엔진 배치 슬롯에서 동시에 처리하고, --max-context는 슬롯끼리 나눠 쓴다. --parallel 4 --max-context 262144이면 슬롯마다 65536 토큰이다.
--slot-full-context를 주면 모든 슬롯이 전체 --max-context를 받지만 KV 캐시는 N배가 된다. 슬롯의 KV 캐시는 전문가 캐시에서 떼어 온다.
동시 요청을 늘리면 요청당 컨텍스트나 전문가에게 돌아갈 메모리가 줄어드는 맞교환이다.
precision 문서가 다루는 시험 범위
정밀도 문서의 시험 구성은 400W 전력 제한의 RTX 5090 한 장과 피어 전문가 계층용 RTX 5060 Ti다. 400W는 두 GPU의 합산 소비 전력이 아니다.
전문가 계층을 고정한 상태에서 275개 greedy 프롬프트 모두 MTP 사용 여부와 무관하게 같은 토큰을 냈다. 프롬프트는 19~395 토큰에 새 토큰 256개로, 문서 스스로 긴 컨텍스트가 아닌 디코드 경로 시험이라고 밝혔다.
전문가가 CPU와 GPU 사이를 옮겨 다니면 반올림이 달라질 수 있다고도 적었다. 품질은 llama.cpp Q8_0 기준과 비교하며, 20청크보다 100청크 결과를 비교 대상으로 삼는다.
모두 프로젝트 자체 시험이며 모든 코딩·추론 작업에서 같은 결과를 보장하지는 않는다.
품질 수용과 메모리 배치는 별개의 시험
이 조건들은 두 가지 수용 질문으로 갈린다. 선택한 설정이 의도한 작업과 프롬프트 길이에서 받아들일 만한 답을 내는지, 그 메모리 배치가 예상 사용자 수에서 필요한 지연을 맞추는지다.
짧은 결정적 일치 시험은 구현 변경을 추적하는 데 쓸모 있지만 작업 단위 검증을 대신하지는 않는다. 여러 요청의 합산 처리량이 늘었다고 단일 요청이 빨리 끝난다는 뜻도 아니다.
실효 설정과 슬롯 메모리를 확인하는 실행 예
Blackwell 워크스테이션에서 시험한다면 모델 팩 리비전, 엔진 빌드, 설정 파일을 한 묶음으로 남기고 산문·구조화 출력·동시 서비스를 따로 잰다. README가 문서화한 실행과 지표 확인은 아래 형태다.
bin/basalt serve --config basalt_config.json --parallel 4 --max-context 262144
curl http://127.0.0.1:8080/metrics
README에 따르면 서버는 시작할 때 장치마다 [server] kv cache: 줄을 출력하고, 슬롯이 전문가 캐시를 지나치게 잠식하면 경고를 낸다. /metrics는 live.slots의 total, active, queue_depth를 보고한다.
긴 대화 이력에 기대는 작업이라면 짧은 프롬프트 일치 결과로 외삽하지 않고 그 이력 자체로 평가하는 편이 현실적이다. 이 글을 위해 Basalt를 실행하지는 않았다.
Basalt의 처리량 수치는 엔진 성능이라기보다 모델 팩, 설정 파일, 슬롯 메모리 배치를 합친 결과물로 읽어야 정확하다.