一款以不到100万参数将英语语音转换为文字的小型模型已公开。它为希望以小文件部署语音识别功能的开发者提供了选择,但除了体积,还需考察识别错误和运行条件。
1. 重复使用相同权重的结构
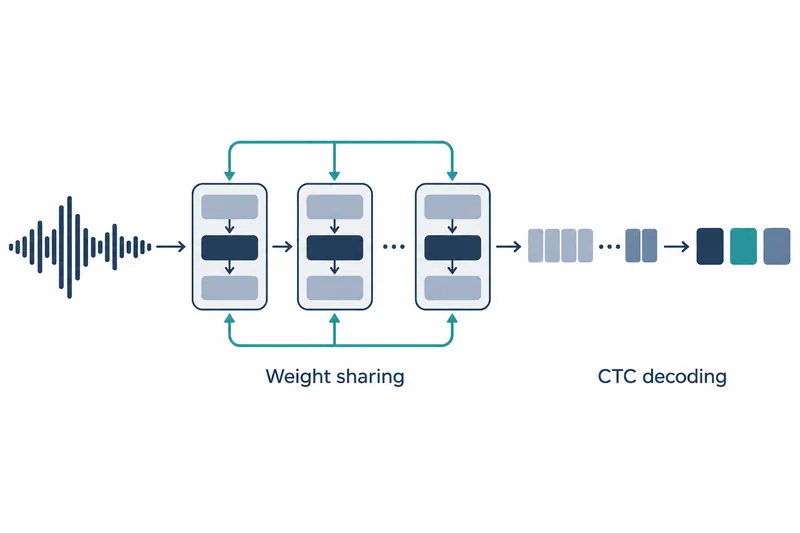
AuroraASR-1M将4个Conformer-lite块各应用两次,总参数量为949,073。它不为每个计算阶段设置独立权重,而是复用相同的训练参数,并通过处理语音与文字对齐的CTC方式生成结果。
训练仅使用LibriSpeech的960小时语音,未使用其他语音或文本数据。379轮训练耗时约10小时,设备为RTX Pro 6000。输入为16kHz单声道英语语音,输出以小写字母为主,不提供标点和大小写区分。
2. 解读错误率时也要看评估方式
词错误率衡量相较于正确答案,单词被错误插入、删除或替换的程度,数值越低越好。使用32位权重时,LibriSpeech的test-clean结果为11.43%,test-other为26.50%。评估采用每一步选择最可能输出的贪心解码,未使用外部语言模型。
模型卡引用的Femto-ASR拥有239万参数,在相同的两个评估集上分别报告了10.95%、25.36%。但原文明示,竞品数据来自各自的模型卡或论文,文本归一化不同时不构成严格比较。不能将其视为在同一环境下重新测量的排名。
该模型在经过小写转换和标点去除的文本上计算错误率。训练过程中使用验证集选择模型,测试集仅用于最终评估。
3. 量化的收益在于存储空间
权重文件在32位时为3.81MB,16位时为1.91MB,8位时为1.06MB。在相同评估方式下,16位和8位的词错误率在test-clean上分别约为11.42%、11.43%,在test-other上约为26.48%、26.54%。低精度下报告的错误率变化也很小。
8位方案将权重存储为小整数,在计算时还原。它能减少下载体积和内存占用,无需额外运行环境即可在CPU和GPU上使用,但不会加快算术运算本身。这是降低存储成本的选择,而非保证计算加速的选择。
4. 速度还取决于预处理条件
实时系数是处理时间除以语音时长,等于1表示与播放时长相同,数值越低越快。以32位、批大小1处理test-clean中100条、共13.3分钟的语音时,GPU为0.0007,CPU为0.0023。两项数值均包含语音特征提取和文字转换。
GPU为NVIDIA RTX PRO 6000 Blackwell Server Edition,特征提取使用了主机CPU的20个线程。CPU测量采用绑定单个核心的单线程条件,未给出具体CPU型号。难以将这些数值推广为任意设备上可获得的速度。
5. 加载时需允许仓库代码
以下是原文示例中加载模型和特征提取器的部分。由于使用仓库中的自定义代码,需要设置trust_remote_code=True。
import soundfile as sf
from transformers import AutoModelForCTC, AutoFeatureExtractor

repo = "AuroraAI-Research/AuroraASR-1M"
model = AutoModelForCTC.from_pretrained(repo, trust_remote_code=True).eval() # FP32
# model = AutoModelForCTC.from_pretrained(repo, subfolder="int8", trust_remote_code=True).eval() # INT8
# model = AutoModelForCTC.from_pretrained(repo, subfolder="fp16", trust_remote_code=True).half().cuda().eval() # FP16
fe = AutoFeatureExtractor.from_pretrained(repo, trust_remote_code=True)
原文将音频文件读取为浮点数组,并用model.transcribe(wav).__getitem__(0)输出结果。上述代码仅摘录其中的加载阶段,实际转换需要符合前述输入格式的语音数组。
AuroraASR-1M适合在优先考虑部署体积小时评估,是否采用应结合报告的错误率与实际运行条件来判断。