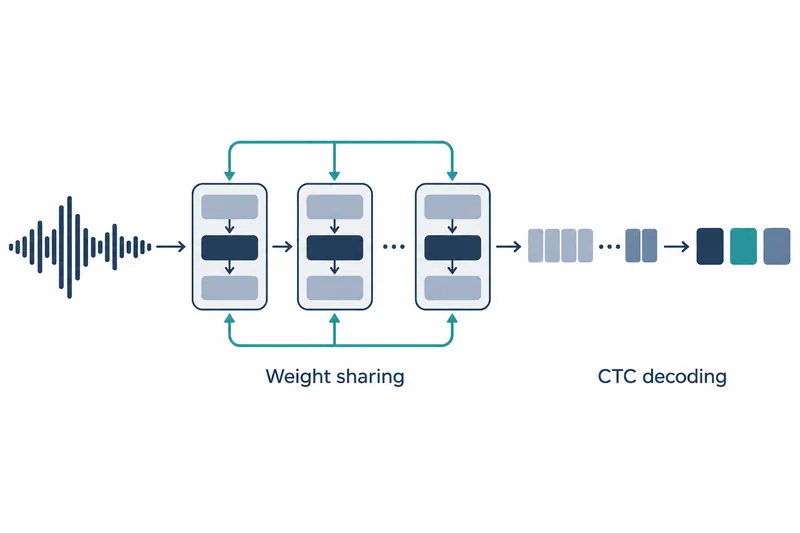
100万個未満のパラメータで英語音声を文字に変換する小型モデルが公開された。小さなファイルで音声認識機能を配布したい開発者に選択肢を提供するが、容量だけでなく認識エラーや実行条件も併せて確認する必要がある。
1. 同じ重みを繰り返し使う構造
AuroraASR-1MはConformer-liteブロック4個をそれぞれ2回適用し、総パラメータ数は949,073個だ。計算段階ごとに別の重みを持たせる代わりに同じ学習済みの値を再利用し、音声と文字の対応付けを処理するCTC方式で結果を生成する。
学習にはLibriSpeechの960時間の音声のみを使用し、ほかの音声やテキストデータは使っていない。379回の学習に約10時間かかり、使用機器はRTX Pro 6000だった。入力は16kHzの単一チャネルの英語音声で、出力は小文字中心で句読点や大文字・小文字の区別には対応しない。
2. 誤り率は評価方法も併せて読む必要がある
単語誤り率は、正解と比較して単語を誤って挿入、削除、置換した程度を示し、低いほどよい。32ビットの重みでLibriSpeechのtest-cleanでは11.43%、test-otherでは26.50%を記録した。各段階で最も有力な出力を選ぶ貪欲デコーディングを使い、外部言語モデルは使用していない。
モデルカードが引用するFemto-ASRは、パラメータ239万個で同じ2つの評価セットにおいて、それぞれ10.95%、25.36%を報告した。ただし、競合モデルの数値は各モデルのカードや論文から引用されており、テキスト正規化が異なれば厳密な比較にはならないと原文は明記している。同一環境で再測定した順位として読むべきではない。
このモデルは、小文字化と句読点の除去を適用したテキストで誤り率を計算した。学習中のモデル選択には検証セットを使い、テストセットは最終評価にのみ使用した。
3. 量子化の利点はストレージにある
重みファイルは32ビットで3.81MB、16ビットで1.91MB、8ビットで1.06MBだ。同じ評価方法で、16ビットと8ビットの単語誤り率はtest-cleanでそれぞれ約11.42%、11.43%、test-otherで約26.48%、26.54%だった。低精度でも、報告された誤り率の変化は小さい。
8ビット方式は、重みを小さな整数で保存し、計算時に復元する。ダウンロード容量とメモリを削減し、専用の実行環境なしでCPUとGPUで使えるが、算術演算自体を高速化するものではない。保存コストを抑える選択であり、演算の高速化を保証する選択ではない。
4. 速度には前処理の条件も付く
処理時間を音声の長さで割ったリアルタイム係数は、1なら再生時間と同じで、低いほど速い。32ビット・バッチサイズ1でtest-cleanの発話100個、計13.3分を処理した場合、GPUは0.0007、CPUは0.0023だった。いずれも音声特徴抽出と文字変換を含む値だ。
GPUはNVIDIA RTX PRO 6000 Blackwell Server Editionで、特徴抽出にはホストCPUのスレッド20個を使用した。CPUの測定は1コアに固定したシングルスレッド条件で、具体的なCPUモデルは示されていない。この数値を任意の機器で得られる速度として一般化するのは難しい。
5. リポジトリのコードを許可して読み込む
以下は、原文の例からモデルと特徴抽出器を読み込む部分を示したものだ。リポジトリのカスタムコードを使うため、trust_remote_code=Trueの設定が必要になる。
import soundfile as sf
from transformers import AutoModelForCTC, AutoFeatureExtractor

repo = "AuroraAI-Research/AuroraASR-1M"
model = AutoModelForCTC.from_pretrained(repo, trust_remote_code=True).eval() # FP32
# model = AutoModelForCTC.from_pretrained(repo, subfolder="int8", trust_remote_code=True).eval() # INT8
# model = AutoModelForCTC.from_pretrained(repo, subfolder="fp16", trust_remote_code=True).half().cuda().eval() # FP16
fe = AutoFeatureExtractor.from_pretrained(repo, trust_remote_code=True)
原文では、音声ファイルを浮動小数点数の配列として読み込み、model.transcribe(wav).__getitem__(0)で結果を出力する。上のコードはそのうち読み込み段階のみを抜粋したもので、実際の変換には前述の入力形式の音声配列が必要だ。
AuroraASR-1Mは配布容量の小ささを優先する際に検討するモデルであり、導入の判断では報告された誤り率と実際の実行条件を併せて基準にする必要がある。