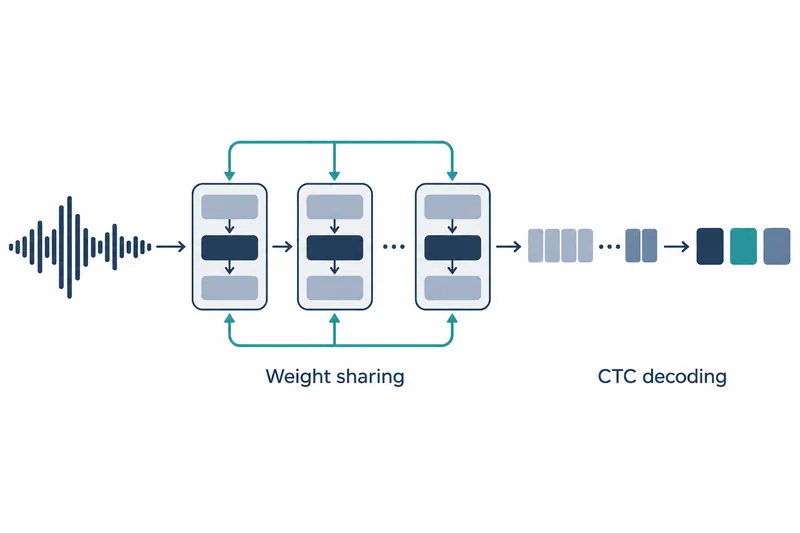
100만 개 미만의 파라미터로 영어 음성을 글로 바꾸는 소형 모델이 공개됐다. 작은 파일로 음성 인식 기능을 배포하려는 개발자에게 선택지를 제공하지만, 용량뿐 아니라 인식 오류와 실행 조건도 함께 살펴야 한다.
1. 같은 가중치를 반복해서 쓰는 구조
AuroraASR-1M은 Conformer-lite 블록 4개를 각각 두 번 적용하며, 총 파라미터는 949,073개다. 계산 단계마다 별도 가중치를 두는 대신 같은 학습 값을 재사용하고, 음성과 글자의 정렬을 처리하는 CTC 방식으로 결과를 만든다.
학습에는 LibriSpeech의 960시간 음성만 사용했으며 다른 음성이나 텍스트 데이터는 쓰지 않았다. 379회 학습에 약 10시간이 걸렸고 장비는 RTX Pro 6000이었다. 입력은 16kHz 단일 채널 영어 음성이며, 출력은 소문자 중심으로 문장부호와 대소문자 구분을 제공하지 않는다.
2. 오류율은 평가 방식까지 함께 읽어야 한다
단어 오류율은 정답과 비교해 단어를 잘못 넣거나 빼거나 바꾼 정도이며 낮을수록 좋다. 32비트 가중치로 LibriSpeech의 test-clean에서 11.43%, test-other에서 26.50%를 기록했다. 매 단계 가장 유력한 출력을 고르는 탐욕적 디코딩을 썼고 외부 언어 모델은 사용하지 않았다.
모델 카드가 인용한 Femto-ASR은 파라미터 239만 개에 같은 두 평가 세트에서 각각 10.95%, 25.36%를 보고했다. 다만 경쟁 모델 수치는 각자의 카드나 논문에서 가져왔고, 텍스트 정규화가 다르면 엄밀한 비교가 아니라고 원문은 명시한다. 이를 같은 환경에서 다시 측정한 순위로 읽어서는 안 된다.
이 모델은 소문자와 문장부호 제거를 적용한 텍스트에서 오류율을 계산했다. 검증 세트로 학습 중 모델을 골랐고, 테스트 세트는 최종 평가에만 사용했다.
3. 양자화의 이익은 저장 공간에 있다
가중치 파일은 32비트에서 3.81MB, 16비트에서 1.91MB, 8비트에서 1.06MB다. 같은 평가 방식에서 16비트와 8비트의 단어 오류율은 test-clean에서 각각 약 11.42%, 11.43%, test-other에서 약 26.48%, 26.54%였다. 낮은 정밀도에서도 보고된 오류율 변화는 작다.
8비트 방식은 가중치를 작은 정수로 저장했다가 계산할 때 복원한다. 다운로드 용량과 메모리를 줄이고 별도 실행 환경 없이 CPU와 GPU에서 쓸 수 있지만, 산술 연산 자체를 빠르게 하지는 않는다. 저장 비용을 줄이는 선택이지 연산 가속을 보장하는 선택은 아니다.
4. 속도에는 전처리 조건도 붙는다
처리 시간을 음성 길이로 나눈 실시간 계수는 1이면 재생 시간과 같고 낮을수록 빠르다. 32비트·배치 크기 1로 test-clean의 발화 100개, 총 13.3분을 처리했을 때 GPU는 0.0007, CPU는 0.0023이었다. 두 값 모두 음성 특징 추출과 문자 변환을 포함한다.
GPU는 NVIDIA RTX PRO 6000 Blackwell Server Edition이며, 특징 추출에는 호스트 CPU의 스레드 20개를 사용했다. CPU 측정은 한 코어에 고정한 단일 스레드 조건이고 구체적인 CPU 모델은 제시되지 않았다. 이 수치를 임의의 기기에서 얻을 속도로 일반화하기는 어렵다.
5. 저장소 코드를 허용해 불러온다
다음은 원문 예시에서 모델과 특징 추출기를 불러오는 부분이다. 저장소의 사용자 정의 코드를 쓰므로 trust_remote_code=True 설정이 필요하다.
import soundfile as sf
from transformers import AutoModelForCTC, AutoFeatureExtractor

repo = "AuroraAI-Research/AuroraASR-1M"
model = AutoModelForCTC.from_pretrained(repo, trust_remote_code=True).eval() # FP32
# model = AutoModelForCTC.from_pretrained(repo, subfolder="int8", trust_remote_code=True).eval() # INT8
# model = AutoModelForCTC.from_pretrained(repo, subfolder="fp16", trust_remote_code=True).half().cuda().eval() # FP16
fe = AutoFeatureExtractor.from_pretrained(repo, trust_remote_code=True)
원문은 음성 파일을 실수형 배열로 읽어 model.transcribe(wav).__getitem__(0)으로 결과를 출력한다. 위 코드는 그중 불러오기 단계만 발췌한 것으로, 실제 변환에는 앞서 설명한 입력 형식의 음성 배열이 필요하다.
AuroraASR-1M은 작은 배포 용량을 우선할 때 검토할 모델이며, 도입 판단은 보고된 오류율과 실제 실행 조건을 함께 기준으로 삼아야 한다.