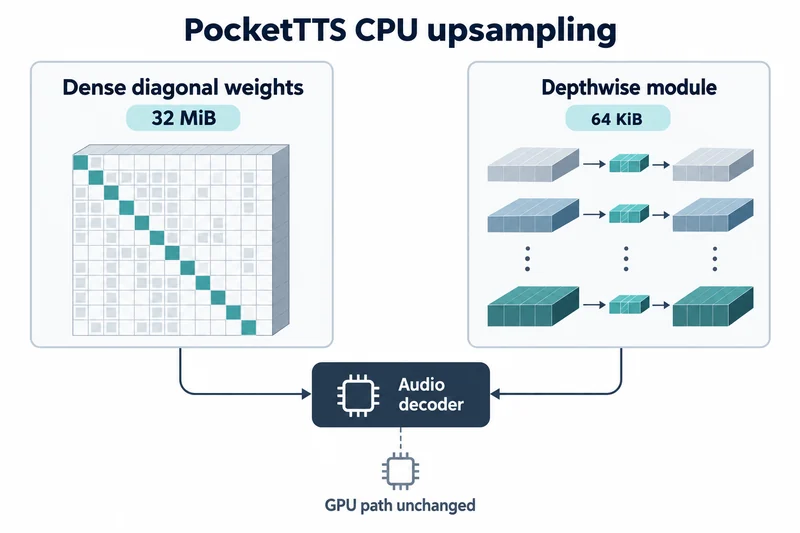
audio.cpp v0.9.1 于10月7日(UTC)发布。在众多变更中,有一项专门针对 PocketTTS CPU 路径的优化。
原来的 CPU Mimi 上采样器把对角权重展开成 32 MiB 的稠密表示。此次变更改用框架中已有的 64 KiB depthwise 模块,并保留流式重叠、会话自有的图缓存和原有 GPU 路径。
只改动了两个 PocketTTS 源文件,没有框架、ggml 或接口变更。
用 depthwise 模块替代稠密展开的原因
对角权重对每个通道独立运算,展开成稠密矩阵就意味着携带一个大部分为零的表示。depthwise(逐通道)模块则保留了这种结构。
这与缩小模型或降低输出质量的提速性质不同。GPU 部署也没有理由期待从这项仅限 CPU 的变更中获益。
在流式语音中,首段音频出现的时间和整句完成的时间是两个不同的问题。稳态解码数字能指出局部瓶颈,但说明不了新会话多快开始发声。
帧中位数与会话 RTF 的测量范围
实时因子(RTF)是处理时间除以音频时长,数值越低越快。在相同的 Debug 构建和请求下,4 线程每帧解码时间从 30.50 ms 降到 10.11 ms,会话 RTF 从 0.461 降到 0.207。
2 线程时为 34.98 ms 到 14.58 ms,会话 RTF 从 0.557 到 0.302。整个进程的 CPU 峰值 RSS 从 663.5 MiB 降到 603.9 MiB。
帧中位数排除了前两次调用,会话数字则包含图初始化。CPU、CUDA 和 Vulkan 上的流式与连续请求输出保持字节一致;Metal 和 HIP 未运行。
以上均为维护者测量,并非独立复现。
HTDemucs CPU 路径变慢的数字
同一版本的 HTDemucs 变更说明“处处更快”并不成立。在 8 秒输入、8 线程的预热请求中,CPU 从 5.056 秒变为 5.407 秒,慢了约7%。
相同条件下,Vulkan(RTX 5090)从 248 ms 降到 148 ms,快了约40%。
旧的 CPU 实现忽略了 HTDemucs 用于时间帧的批次维度。重写后,drums/other 与官方 Python 的余弦相似度从 0.683/0.924 提升到 0.999974/0.999998,因此这是正确性不同的路径之间的时间比较。
在相同条件下重新测量的检查点
做部署决策时,保持比较条件一致是更现实的做法。固定模型、输入文本、线程数和输出模式,并分别记录新会话与重复请求的表现。
除了耗时,流式分块之间和连续请求之间的连续性也值得检查。这些是可在目标系统上进行的检查,并非本文已做的测试。
发布二进制可能要求的 AVX-512 支持,可以先用 Linux 标准工具确认。
grep -o -m1 avx512f /proc/cpuinfo如果输出为空,适用的是随版本发布的 portable 构建(例如 audio-v0.9.1-bin-ubuntu-x64-cpu-portable.tar.gz)。
即使这一 CPU 阶段变便宜,如果其他阶段主导请求时间,应用层面的收益也会小于局部改进。不过,仅仅避免了大型临时表示,在内存方面似乎就有价值。
AVX-512 构建与 portable 构建
发布说明指出,由于 GitHub 运行器上的自动 CPU 检测,近期构建往往以 AVX-512 为目标。如遇崩溃,说明建议使用兼容性更广的 portable 版本。
由不兼容可执行文件引起的崩溃,并不能证明模型或优化本身不受支持。
这次补丁不是整个库的速度倍数,而是修正了 PocketTTS CPU 上采样器这一条路径的成本结构。