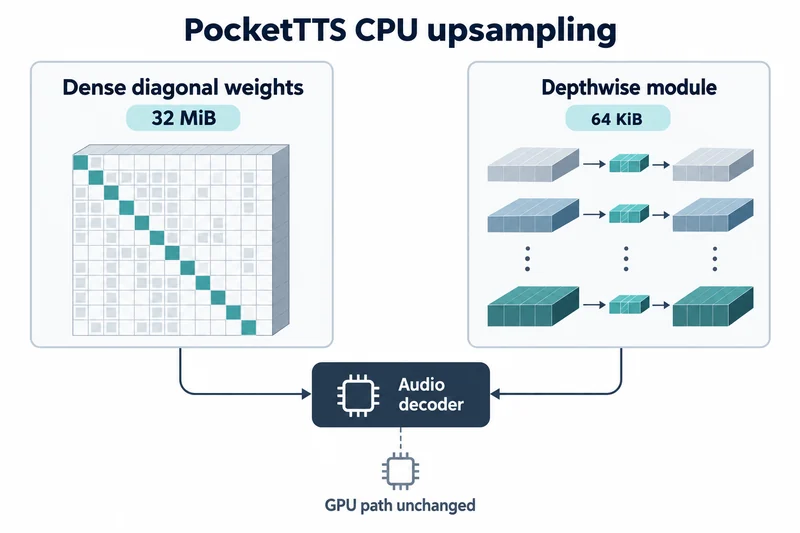
audio.cpp v0.9.1が10月7日(UTC)にリリースされた。多くの変更の中に、PocketTTSのCPU経路を狭く狙った最適化が含まれている。
従来のCPU Mimiアップサンプラーは、対角重みを32MiBの密な表現に展開していた。今回の変更はフレームワークに既にある64KiBのdepthwiseモジュールを使い、ストリーミングのオーバーラップ、セッション所有のグラフキャッシュ、元のGPU経路は維持する。
変更されたのはPocketTTSのソース2ファイルだけで、フレームワーク、ggml、インターフェースの変更はない。
密な展開の代わりにdepthwiseモジュールを使う理由
対角重みはチャネルごとに独立した演算なので、密な行列に展開するとほとんどがゼロの表現を持ち回ることになる。depthwise(チャネル単位)モジュールはその構造をそのまま生かす。
モデルを小さくしたり出力品質を下げたりする改善とは性質が異なる。GPUでの運用が、このCPU専用の変更から利益を期待する根拠もない。
ストリーミング音声では、最初の音声が出るまでの時間と発話全体を終えるまでの時間は別の問いだ。定常状態のデコーダー数値は局所的なボトルネックを示すが、新しいセッションが話し始める速さまでは示さない。
フレーム中央値とセッションRTFの測定範囲
実時間係数(RTF)は処理時間を音声の長さで割った値で、低いほど速い。同じDebugビルドとリクエストで、4スレッドのフレーム当たりデコード時間は30.50msから10.11msに、セッションRTFは0.461から0.207に下がった。
2スレッドでは34.98msから14.58ms、セッションRTFは0.557から0.302だった。プロセス全体のCPUピークRSSは663.5MiBから603.9MiBに減った。
フレーム中央値は最初の2回の呼び出しを除き、セッションの数値はグラフ初期化を含む。CPU、CUDA、Vulkanでストリーミングと連続リクエストの出力はバイト単位で一致し、MetalとHIPは実行していない。
いずれもメンテナーの測定であり、独立した再現ではない。
HTDemucs CPU経路で遅くなった数値
同じリリースのHTDemucsの変更は、あらゆる場所で速くなったという要約が当てはまらないことを示す。8秒の入力、8スレッドのウォームリクエストで、CPUは5.056秒から5.407秒へ約7%遅くなった。
同じ条件でVulkan(RTX 5090)は248msから148msへ約40%速くなった。
旧CPU実装は、HTDemucsが時間フレームに使うバッチ次元を無視していた。書き換え後、公式Pythonに対するdrums/otherのコサイン類似度は0.683/0.924から0.999974/0.999998に上がり、正確性の異なる経路同士の時間比較ということになる。
同じ条件で測り直すためのチェックポイント
導入判断では、比較条件をそろえる方法が現実的だ。モデル、入力テキスト、スレッド数、出力モードを固定し、新規セッションと繰り返しリクエストを分けて記録する。
経過時間だけでなく、ストリーミングのチャンク間や連続リクエスト間の連続性も確認対象だ。本記事で行ったテストではなく、対象システムで実施できる確認である。
リリースバイナリが要求し得るAVX-512への対応は、Linuxの標準ツールで先に確認できる。
grep -o -m1 avx512f /proc/cpuinfo出力が空なら、リリースと一緒に配布されたportableビルド(例:audio-v0.9.1-bin-ubuntu-x64-cpu-portable.tar.gz)が対象になる。
そのCPU段階が軽くなっても、別の段階がリクエスト時間を支配していれば、アプリケーション全体の効果は局所的な改善より小さくなる。それでも大きな一時表現を避けたこと自体に、メモリ面の価値はあるように見える。
AVX-512ビルドとportableビルド
リリースノートは、GitHubランナーでの自動CPU検出のため、最近のビルドがAVX-512を対象にしがちだと記している。クラッシュする場合は、互換性の広いportable版を使うよう案内している。
互換性のない実行ファイルによるクラッシュは、モデルや最適化そのものが非対応である証拠ではない。
このパッチはライブラリ全体の速度倍率ではなく、PocketTTSのCPUアップサンプラーという一つの経路のコスト構造を正した変更だ。