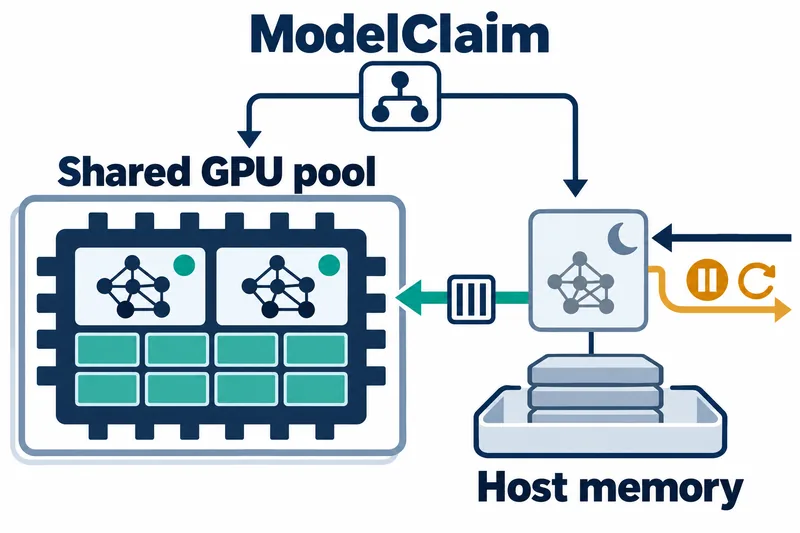
AIBrix 团队在 v0.8.0 中引入了实验性功能 ModelClaim,将模型与运行环境分开管理。它在长期保留的 GPU 池中启动各模型的引擎,让闲置引擎休眠,使多个模型共享 GPU 内存。
介绍文章标注的发布日期为 10 月 12 日,而 GitHub API 记录的 v0.8.0 版本公开日期为 10 月 13 日。
项目希望解决的问题是,即使请求稀少,模型仍会持续占用专属 GPU 容量。反过来,如果彻底释放闲置模型的运行资源,下次请求到来时就需要冷启动,重新准备运行环境。
ModelClaim 长期保留 Kubernetes 的运行单元 Pod,同时单独管理其中的模型引擎。这种做法不再为每个模型持续保留整套运行环境,而是调节引擎的生命周期和内存使用。
休眠引擎的预留空间
控制器负责模型放置,并设定 KV 缓存上限。用于复用先前 Token 信息的 KV 缓存由 kvcached 管理,它会灵活调节引擎之间的可用空间。
休眠模型默认保留全部预留空间,以确保有足够空间重新唤醒。开启 noWakeReserveWhileAsleep 后,其他模型也可以使用这部分预留空间。
让出预留空间后,恢复流程会有所不同。系统可能需要先让同一资源池中的其他闲置模型休眠,在另一个 Pod 中加载新引擎,或等待空间释放。
网关不会一直挂起请求,等待这一过程完成。对于处于休眠、启动或恢复状态的模型,它会返回 HTTP 503 和 Retry-After: 10。
等待空间时,Retry-After 的值为 20;迁移到其他 Pod 时,该值为 30。这些值只是以秒为单位的重试提示,并不保证相应时间过后模型就已就绪或请求就已处理完成。
39 个模型驻留与并发处理的区别
项目报告称,在配备 8 块 NVIDIA H20 GPU 的节点上驻留了 39 个模型,参数规模为 15 亿至 320 亿。其中,处于休眠状态的 80 亿参数模型仍占用 1.7–3.2 GiB GPU 内存。
对比基准是仅加载该模型权重所需的约 15 GiB。因此,这组数据展示的是休眠模型的驻留成本,而不是在维持相同吞吐量的情况下同时运行更多模型的结果。
同一份报告称,每块 GPU 约有 5 个模型驻留,其中约 3 个同时处于唤醒状态。报告还介绍了收到请求后约 4 秒恢复服务的案例,但前提是 GPU 上有空闲空间。
测试范围
项目的驻留测试报告没有提供完整的请求构成、测试时长、服务目标或失败率对比。仅凭驻留模型数量,很难判断实际运行负载下的处理性能。
当前指南明确列出的测试范围是 vLLM、H20,以及在单个 Pod 内将模型分布到 1 块或 2 块 GPU 上的张量并行配置。节点配备 8 块 GPU,并不意味着已经验证了单个模型的 8 GPU 并行运行。
张量并行度大于 2、每个 Pod 超过 2 块 GPU,以及其他 GPU 型号均未经测试。按模型层划分的流水线并行也未经测试,而通过副本分担请求的数据并行则不受支持。一个 ModelClaim 运行一个引擎。
内存管理责任
根据当前指南,GPU 放置决策依赖运维人员声明的 perGPU.maximumFootprint 和 perGPU.kvFloor。控制器不会测量模型的实际占用量,kvcached 限制的也仅是 KV 缓存。如果申报的占用量偏低,可能导致 GPU 内存不足。
主机 RAM 是另一个问题。1 级休眠会将权重从 GPU 移至主机 RAM,但控制器在做放置或休眠决策时不会计入这部分用量。因此,无论是否将 GPU 预留空间让给其他模型,休眠模型增多都可能导致节点 RAM 不足。
运行时与访问控制
当前指南公开的运行时基于 vLLM,仅提供 linux/amd64 版本。这些构建产物从 main 分发,不包含在 AIBrix 发布版本中。SGLang 需要用户自行提供镜像,且未经测试。
指南说明,运行时代理的 8080 端口没有身份验证,引擎的 20000–20999 端口用于接受休眠与恢复控制。指南建议限制对这些控制通道的网络访问。
ModelClaim 的优势在于让更多请求稀少的模型保持待用状态。保留预留空间可以保障恢复所需的余量;共享这部分空间则能增加其他模型可用的 GPU 容量,但恢复时可能需要重新获得空间。
项目报告的约 4 秒,是有条件的引擎恢复案例,并不等同于客户端收到响应所需的时间。如果客户端按照 Retry-After: 10 重试,即使引擎提前就绪,也可能在 10 秒后才发送下一个请求。
分别记录首个请求与就绪时间
在自己的环境中,可以先检查 noWakeReserveWhileAsleep 设置,确认是否保留休眠模型的预留空间,再一并记录首个请求的时间、HTTP 状态和 Retry-After 值。
随后观察 ModelClaim 的就绪状态,记录确认其就绪的时间,并单独记录客户端的重试时间和结果。分开记录后,就能区分请求收到的状态、服务器的重试提示、实际就绪时间与客户端等待时间。
今后除了驻留模型数量,还值得关注复用预留空间带来的恢复等待,以及 1 级休眠的主机 RAM 用量。在集中部署请求稀少模型的环境中,这两项资源条件和客户端的重试处理,可能决定其实际适用范围。
ModelClaim 是一种让更多模型保持待用状态的方式,但这种收益并不意味着它能保证立即处理休眠模型的首个请求。