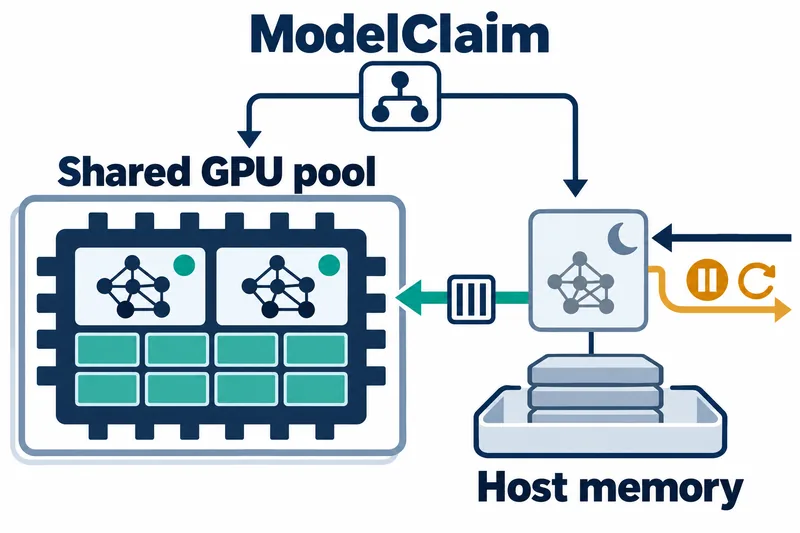
AIBrix 팀은 v0.8.0에서 모델을 실행 환경과 분리해 관리하는 실험적 기능 ModelClaim을 도입했다. 오래 유지하는 GPU 풀 안에서 모델별 엔진을 띄우고, 쓰지 않는 엔진을 재워 여러 모델이 GPU 메모리를 나눠 쓰는 방식이다.
소개 글은 10월 12일자로 게시됐으며, GitHub API가 기록한 v0.8.0 릴리스 공개일은 10월 13일이다.
프로젝트가 겨냥한 문제는 요청이 드문 모델도 전용 GPU 용량을 계속 차지한다는 점이다. 반대로 유휴 모델의 실행 자원을 완전히 없애면 다음 요청 때 다시 준비하는 콜드 스타트가 필요하다.
ModelClaim은 쿠버네티스의 실행 단위인 Pod를 오래 유지하면서 그 안의 모델 엔진을 따로 관리한다. 모델마다 실행 환경 전체를 계속 붙잡아 두는 대신, 엔진의 수명과 메모리 사용을 조절하려는 접근이다.
잠든 엔진의 예약 공간
컨트롤러는 모델을 배치하고 KV 캐시의 한도를 정한다. 이전 토큰의 정보를 재사용하기 위한 KV 캐시는 kvcached가 관리하며, 엔진 사이에서 사용 가능한 공간을 탄력적으로 조절한다.
잠든 모델은 기본적으로 다시 깨어날 공간을 확보하도록 예약량 전체를 유지한다. noWakeReserveWhileAsleep을 켜면 이 예약 공간도 다른 모델이 사용할 수 있다.
예약 공간을 내준 뒤에는 복귀 절차가 달라진다. 유휴 이웃 모델을 먼저 재우거나, 다른 Pod에 새 엔진을 적재하거나, 공간이 생길 때까지 기다려야 할 수 있다.
게이트웨이는 이 과정이 끝날 때까지 요청을 붙들고 있지 않는다. 잠들었거나 시작·복귀 중인 모델에는 HTTP 503과 Retry-After: 10을 반환한다.
공간을 기다리는 상태의 Retry-After 값은 20이고, 다른 Pod로 옮기는 상태는 30이다. 각 값은 초 단위의 재시도 안내일 뿐, 해당 시간이 지나면 모델 준비나 요청 처리가 완료된다는 보장은 아니다.
39개 상주와 동시 처리의 차이
프로젝트는 NVIDIA H20 GPU 8개를 갖춘 노드에 매개변수 15억~320억 개 규모의 모델 39개를 상주시켰다고 보고했다. 이 가운데 잠든 매개변수 80억 개 모델은 GPU 메모리 1.7~3.2 GiB를 유지했다.
비교 기준은 해당 모델의 가중치만 적재하는 데 필요한 약 15 GiB다. 따라서 이 수치는 잠든 모델의 상주 비용을 보여주며, 같은 처리량으로 더 많은 모델을 동시에 실행했다는 결과는 아니다.
같은 보고에서 GPU당 약 5개 모델이 상주했고 약 3개가 동시에 깨어 있었다. 요청 후 약 4초 만에 다시 서비스한 사례도 소개했지만, GPU에 여유 공간이 있을 때라는 조건이 붙는다.
시험 범위
프로젝트의 상주 시험 보고에는 전체 요청 구성, 시험 시간, 서비스 목표나 실패율 비교가 제시되지 않았다. 상주 모델 수만으로 운영 부하에서의 처리 성능을 판단하기는 어렵다.
현재 가이드가 시험했다고 밝힌 범위는 vLLM과 H20, 한 Pod 안에서 GPU 1개 또는 2개에 모델을 나누는 텐서 병렬 구성이다. 8개 GPU를 갖춘 노드라는 설명이 모델 하나의 8-GPU 병렬 실행까지 검증했다는 뜻은 아니다.
텐서 병렬도 2 초과, Pod당 GPU 2개 초과와 다른 GPU 종류는 미시험이다. 모델의 층을 나누는 파이프라인 병렬도 미시험이며, 복제본으로 요청을 나누는 데이터 병렬은 지원하지 않는다. ModelClaim 하나는 엔진 하나를 실행한다.
메모리 책임
현재 가이드에 따르면 GPU 배치는 운영자가 선언한 perGPU.maximumFootprint와 perGPU.kvFloor를 신뢰한다. 컨트롤러는 모델의 실제 점유량을 측정하지 않으며, kvcached가 제한하는 것은 KV 캐시뿐이다. 점유량을 작게 신고하면 GPU 메모리가 부족해질 수 있다.
호스트 RAM은 별도 문제다. 레벨 1 절전은 가중치를 GPU에서 호스트 RAM으로 옮기지만, 컨트롤러는 이 사용량을 배치나 절전 결정에 반영하지 않는다. 따라서 GPU 예약 공간을 다른 모델에 내주는지와 별개로, 잠든 모델이 많아지면 노드 RAM이 부족해질 수 있다.
런타임·접근 통제
현재 가이드의 공개 런타임은 vLLM 기반이며 linux/amd64만 제공한다. main에서 배포되는 산출물로 AIBrix 릴리스에는 포함되지 않는다. SGLang은 사용자 제공 이미지가 필요하고 미시험이다.
가이드는 런타임 에이전트의 8080 포트에 인증이 없고, 엔진의 20000~20999 포트가 절전·복귀 제어를 받는다고 설명한다. 이런 제어 경로에 대한 네트워크 접근 제한을 권고한다.
ModelClaim의 이점은 요청이 드문 모델을 더 많이 준비해 두는 데 있다. 예약 공간을 유지하면 복귀 여유를 보호하고, 이를 공유하면 다른 모델이 쓸 GPU 용량이 늘어나는 대신 복귀 때 공간 확보가 필요할 수 있다.
프로젝트가 보고한 약 4초는 조건부 엔진 복귀 사례이지, 클라이언트가 응답을 받기까지 걸리는 시간과 같지 않다. Retry-After: 10에 맞춰 재시도하는 클라이언트라면 엔진이 먼저 준비돼도 10초 뒤에 다음 요청을 보낼 수 있다.
첫 요청과 준비 완료를 나눠 기록
자신의 환경에서는 먼저 noWakeReserveWhileAsleep 설정으로 잠든 모델의 예약 공간을 유지하는지 확인할 수 있다. 이어 첫 요청의 시각, HTTP 상태, Retry-After 값을 함께 기록한다.
그다음 ModelClaim의 준비 상태를 관찰해 준비 완료를 확인한 시각을 남기고, 클라이언트의 재시도 시각과 결과를 별도로 기록한다. 이렇게 나누면 요청이 받은 상태, 서버의 재시도 안내, 실제 준비 완료와 클라이언트의 대기 시간을 구분해 볼 수 있다.
앞으로 지켜볼 지점은 상주 모델 수와 함께, 예약 공간 재사용에 따른 복귀 대기와 레벨 1 절전의 호스트 RAM 사용이다. 요청이 드문 모델을 모으는 환경에서는 이 두 자원 조건과 클라이언트의 재시도 처리가 실제 활용 범위를 가를 것으로 보인다.
ModelClaim은 더 많은 모델을 준비해 두는 방식이며, 그 이득은 잠든 모델의 첫 요청을 즉시 처리한다는 보장과는 별개다.