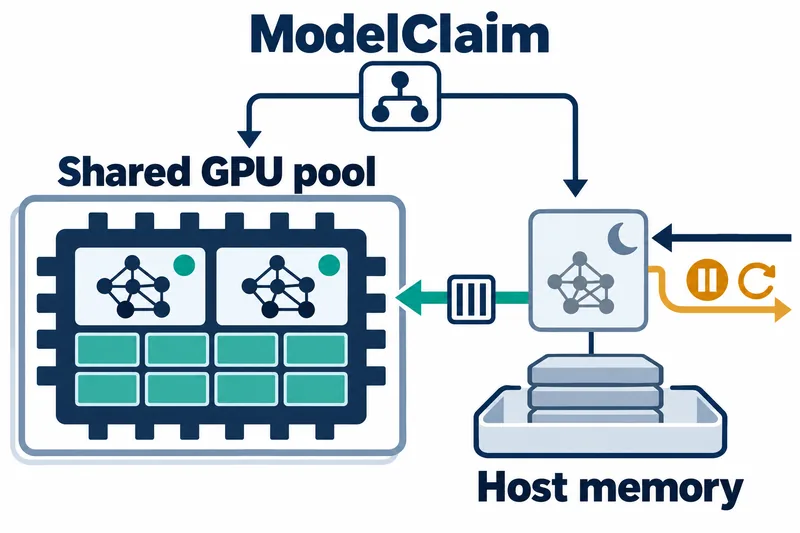
AIBrixチームはv0.8.0で、モデルを実行環境から切り離して管理する実験的な機能ModelClaimを導入した。長期間維持するGPUプール内でモデルごとのエンジンを起動し、使っていないエンジンを休止させて、複数のモデルでGPUメモリを分け合う仕組みだ。
紹介記事の掲載日は10月12日で、GitHub APIに記録されたv0.8.0リリースの公開日は10月13日だ。
プロジェクトが解決を目指したのは、リクエストが少ないモデルも専用のGPU容量を占有し続けるという問題だ。一方、アイドル状態のモデルの実行リソースを完全に解放すると、次のリクエスト時に再び準備するコールドスタートが発生する。
ModelClaimは、Kubernetesの実行単位であるPodを長期間維持し、その中のモデルエンジンを個別に管理する。モデルごとに実行環境全体を確保し続けるのではなく、エンジンのライフサイクルとメモリ使用量を調整するアプローチだ。
休止エンジンの予約領域
コントローラーはモデルを配置し、KVキャッシュの上限を設定する。過去のトークンの情報を再利用するためのKVキャッシュはkvcachedが管理し、エンジン間で利用可能な領域を柔軟に調整する。
休止中のモデルは、デフォルトでは復帰に必要な領域を確保するため、予約量をすべて維持する。noWakeReserveWhileAsleepを有効にすると、この予約領域も他のモデルが利用できる。
予約領域を開放すると、復帰の手順が変わる。アイドル状態にある周囲のモデルを先に休止させるか、別のPodに新しいエンジンをロードするか、空き領域ができるまで待つ必要が生じうる。
ゲートウェイは、この処理が終わるまでリクエストを保持しない。休止中、起動中、復帰中のモデルにはHTTP 503とRetry-After: 10を返す。
空き領域を待つ状態ではRetry-Afterの値は20、別のPodへ移動する状態では30となる。いずれも秒単位の再試行案内にすぎず、その時間が過ぎればモデルの準備やリクエストの処理が完了するという保証ではない。
39モデルの常駐と同時処理の違い
プロジェクトは、NVIDIA H20 GPUを8基搭載したノードに、パラメーター数15億〜320億の39モデルを常駐させたと報告している。このうち、休止中の80億パラメーターモデルが保持したGPUメモリは1.7〜3.2 GiBだった。
比較対象は、そのモデルの重みだけをロードするのに必要な約15 GiBだ。したがって、この数値は休止モデルの常駐コストを示しており、同じスループットでより多くのモデルを同時に実行した結果ではない。
同じ報告では、GPU当たり約5モデルが常駐し、約3モデルが同時に稼働していた。リクエストから約4秒でサービスを再開した事例も紹介しているが、GPUに空き領域がある場合という条件が付く。
検証の範囲
プロジェクトの常駐試験の報告には、リクエストの構成全体、試験時間、サービス目標、失敗率の比較が示されていない。常駐モデル数だけでは、運用時の負荷に対する処理性能を判断しにくい。
現行ガイドが検証済みとしているのは、vLLMとH20を使い、1つのPod内の1基または2基のGPUにモデルを分割するテンソル並列構成だ。8基のGPUを搭載したノードという説明は、単一モデルの8-GPU並列実行まで検証したことを意味しない。
テンソル並列度が2を超える構成、Pod当たりのGPUが2基を超える構成、他のGPU種別は未検証だ。モデルの層を分割するパイプライン並列も未検証で、レプリカにリクエストを振り分けるデータ並列は非対応だ。1つのModelClaimが実行するエンジンは1つとなる。
メモリ管理の責任範囲
現行ガイドによると、GPUへの配置は運用者が宣言したperGPU.maximumFootprintとperGPU.kvFloorを信頼する。コントローラーはモデルの実際の占有量を測定せず、kvcachedが制限するのはKVキャッシュだけだ。占有量を過少に申告すると、GPUメモリが不足する可能性がある。
ホストRAMは別の問題だ。レベル1の休止では重みをGPUからホストRAMに移すが、コントローラーはこの使用量を配置や休止の判断に反映しない。そのため、GPUの予約領域を他のモデルに開放するかどうかにかかわらず、休止モデルが増えるとノードのRAMが不足する可能性がある。
ランタイムとアクセス制御
現行ガイドで公開されているランタイムはvLLMベースで、linux/amd64のみ提供される。mainから配布される成果物であり、AIBrixのリリースには含まれない。SGLangにはユーザーが用意するイメージが必要で、未検証だ。
ガイドでは、ランタイムエージェントの8080ポートには認証がなく、エンジンの20000〜20999ポートで休止・復帰の制御を受け付けると説明している。これらの制御経路へのネットワークアクセス制限を推奨している。
ModelClaimの利点は、リクエストが少ないモデルをより多く準備しておけることにある。予約領域を維持すれば復帰用の余裕を確保できる。共有すれば他のモデルが使えるGPU容量が増える一方、復帰時に領域の確保が必要になる場合がある。
プロジェクトが報告した約4秒は、条件付きのエンジン復帰事例であり、クライアントが応答を受け取るまでの時間とは異なる。Retry-After: 10に従って再試行するクライアントは、エンジンが先に準備できても、次のリクエストを送るのが10秒後になる場合がある。
最初のリクエストと準備完了の個別記録
手元の環境では、まずnoWakeReserveWhileAsleepの設定で、休止モデルの予約領域を維持しているか確認できる。続いて、最初のリクエストの時刻、HTTPステータス、Retry-Afterの値を併せて記録する。
その後、ModelClaimの準備状態を観察して準備完了を確認した時刻を残し、クライアントの再試行時刻と結果を別に記録する。こうして分けると、リクエストに返されたステータス、サーバーの再試行案内、実際の準備完了、クライアントの待ち時間を区別できる。
今後の注目点は、常駐モデル数に加え、予約領域の再利用に伴う復帰待ちと、レベル1の休止によるホストRAM使用量だ。リクエストが少ないモデルを集約する環境では、この2つのリソース条件とクライアントの再試行処理が、実際の活用範囲を左右すると考えられる。
ModelClaimはより多くのモデルを準備しておく仕組みであり、その利点と、休止モデルへの最初のリクエストを即座に処理できるという保証は別の話だ。