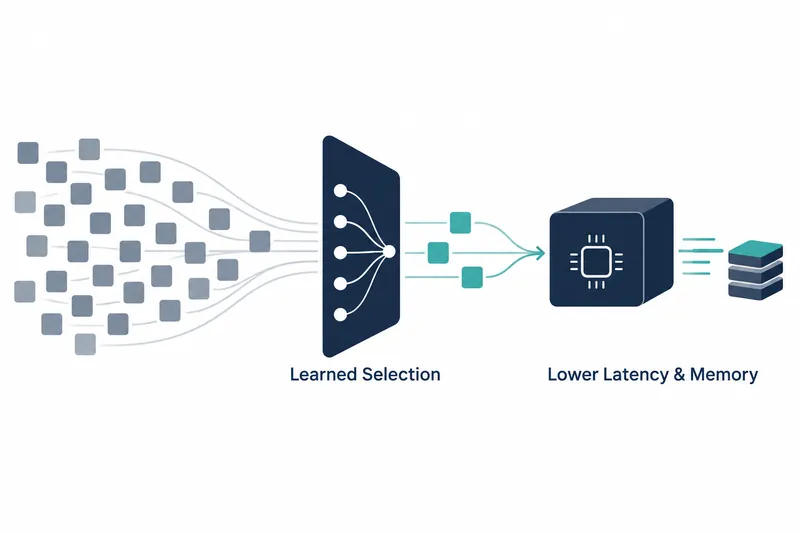
긴 문서에서 중요한 부분을 골라 처리하도록 기존 언어 모델에 더하는 학습형 기능 TokenGate가 공개됐다. 모델 개발자는 필요한 문맥만 위쪽 층에서 처리하게 해 첫 응답까지 걸리는 시간과 메모리 사용을 줄일 수 있다.
1. 기존 모델이 토큰을 고르는 법을 학습
사람이 문서를 훑어보다 중요한 대목을 자세히 읽듯, 모델도 처리할 부분을 고르게 하는 접근이다. 기존 모델은 보통 모든 토큰을 층마다 계산한다. TokenGate는 지정한 층에서 문서 토큰마다 중요도를 매기고, 정한 수만 남겨 그 위의 층으로 보낸다. 남지 않은 토큰은 이후 층의 계산과 그 층들에서 만드는 키·값 캐시, 이전 계산 결과를 저장해 재사용하는 메모리에서 제외된다.
기존의 토큰 선별 방식은 학습 없이 주의 점수, 토큰 간 관련도를 나타내는 값 같은 규칙으로 토큰을 추린다. 논문은 초반 층의 점수만 활용하는 방법이 토큰을 많이 줄이면 정확도 손실을 보였다고 설명한다. TokenGate는 모델과 선별기를 기존 모델을 추가로 학습하는 방식으로 함께 미세 조정해 어떤 토큰을 남길지 학습한다.
2. 선별기와 모델을 함께 미세 조정
학습 때는 토큰을 고르는 점수가 위쪽 층의 주의 계산에도 영향을 주게 해, 어떤 선택이 정답에 도움이 되는지 배우도록 한다. 전체 문맥과 줄인 문맥의 학습 결과를 함께 반영하므로 한 번 학습한 선별기를 여러 토큰 예산에 쓸 수 있다.
저장소의 추론 예시는 문서 구간을 표시하고 남길 토큰 수를 지정하는 방식이다. 아래는 README 코드에서 해당 부분을 그대로 발췌했다.
for k in (None, 2000, 500, 100):          # None = keep every state token
    out = model.generate([ids], tok, max_kept_prefill_tokens=k)
    print(k, f"{out.prefill_s * 1e3:5.0f} ms", out.answers[0])
3. 긴 문맥에서 지연 절감 폭 확대
논문은 Qwen3-1.7B를 16k 길이의 바늘 찾기 과제로 학습하고 더 긴 문맥에서 평가했다. 바늘 찾기는 긴 문서에 심어 둔 특정 사실을 찾아 답하는 과제다.
아래 표는 전체 문맥을 처리하는 미세 조정 모델과 정확도를 맞췄을 때의 결과다. 입력을 처리해 첫 토큰을 내놓기까지 걸리는 시간(TTFT)과 최대 메모리 사용량을 비교했다.
표: 문맥 길이에 따른 TokenGate 절감
조건: Qwen3-1.7B, bf16, 16k 바늘 찾기 과제로 학습, 배치 크기 1, A100 1장, 전체 문맥 대비
단위: 배
| 평가 문맥 길이 | TTFT 속도 향상 | 피크 메모리 절감 |
|---|---|---|
| 16k | 11.3 | 3.42 |
| 32k | 12.8 | 3.43 |
| 64k | 13.0 | 3.43 |
| 128k | 13.0 | 3.43 |
문맥이 길어질수록 속도 향상 폭은 커졌고, 메모리 절감은 3.42~3.43배로 비슷했다. 논문은 게이트 아래 층이 모든 토큰을 처리해 피크 메모리에 영향을 주기 때문이라고 분석한다.
4. 저장소 테스트와 과제별 차이
저장소가 공개한 별도 벤치마크, 성능을 비교하는 표준 시험은 H100 한 장, 배치 크기 1로 학습에서 따로 남겨 둔 테스트 자료를 측정했다. 아래 표의 원본은 학습 전 모델이며, 무가지치기는 게이트와 모델을 과제에 맞게 미세 조정한 뒤 토큰을 모두 남긴 정확도 기준선이다.
K=2000은 문서 토큰을 2000개 남긴 설정이다. 코드 완성 점수는 정답 코드와 얼마나 비슷한지, 의약품 반응 추출 점수는 얼마나 빠짐없이 정확하게 추출했는지를 본다.
표: 저장소 공개 테스트 결과
조건: Qwen3-1.7B 기반, H100 1장, 배치 크기 1, 학습에서 분리한 테스트 자료, K=2000
단위: TTFT는 학습 전 원본 모델 대비 배
| 데이터셋 | 표본 수 | 지표 | 원본 | 무가지치기 | K=2000 | TTFT 속도 향상 |
|---|---|---|---|---|---|---|
| NIAH 바늘 찾기 (16k) | 150 | 정답률 | 0.993 | 1.000 | 1.000 | 6.3 |
| RepoBench-P | 450 | 편집 유사도 | 0.285 | 0.587 | 0.550 | 3.8 |
| BioDEX-Reactions | 450 | F1 | 0.056 | 0.284 | 0.292 | 2.1 |
코드 완성에서는 무가지치기 결과보다 점수가 낮았지만, 의약품 반응 추출에서는 소폭 높았다. 저장소의 별도 바늘 찾기 시연에서는 약 32k 문서에서 100개 토큰을 남겨도 다섯 사례 모두 답을 찾았고 TTFT 속도 향상은 11.18배였다. 이는 다섯 개 문서와 바늘 위치 11~100%, GPU 한 장 조건의 결과다.
5. 속도·메모리 이득과 대가
논문은 본 실험에서 전체 문맥 미세 조정 모델과 정확도를 맞췄을 때 프리필이 1.4~11.3배 빨라지고 피크 메모리는 1.5~3.4배 줄었다고 보고했다. Qwen3-1.7B, bf16, A100 한 장, 배치 크기 1로 여러 과제를 평가한 결과다. 논문 5.1절에서 다음으로 성능이 좋았던 선별 방식 대비 속도 향상은 최대 6.4배, 메모리 절감은 최대 2.1배였다.
추론 비용을 아끼는 대신 선별기를 학습하고 실행 환경을 준비하는 비용이 따른다. 논문 부록의 Qwen3-1.7B, A100 한 장 실험에서 학습 한 단계는 표준 미세 조정보다 1.3배 느렸지만, 다섯 과제의 전체 학습 시간 평균은 표준 방식의 0.8배였다.
기본 구성의 빠른 실행에는 CUDA 커널 빌드가 권장되며, 추론은 커널 없이도 대체 경로로 실행할 수 있다. 학습에서 대체 경로를 쓰려면 이를 명시적으로 선택해야 한다.
정확도 손실도 과제와 토큰 예산에 따라 생겼으며, 논문의 요약 사례에서는 사건은 맞게 요약했지만 이름과 장소를 틀렸다.
TokenGate는 긴 문맥의 프리필을 줄일 실용적 선택지를 제시하지만, 이득은 학습 데이터와 과제에 맞춘 토큰 선별에 달려 있다.