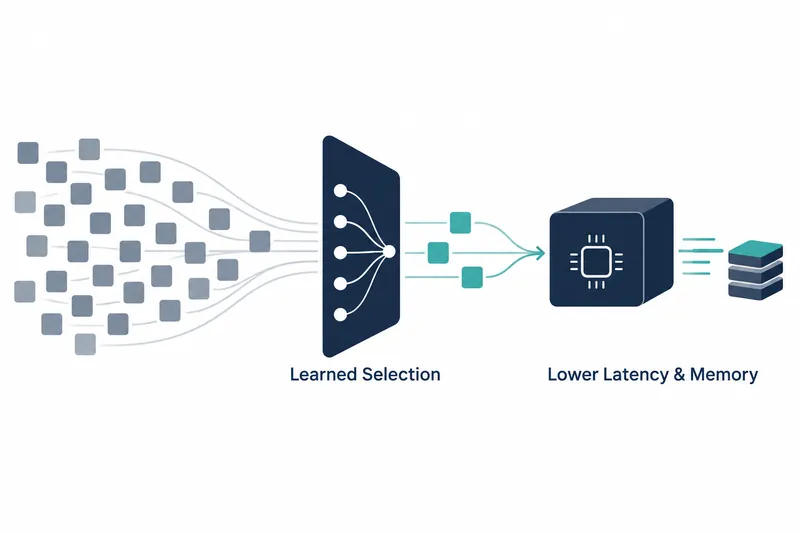
長い文書の重要な部分を選んで処理するため、既存の言語モデルに追加する学習型機能TokenGateが公開された。モデル開発者は必要な文脈だけを上位層で処理させ、最初の応答までの時間とメモリ使用量を減らせる。
1. 既存モデルがトークンの選び方を学習
人が文書に目を通し、重要な箇所を詳しく読むように、モデルにも処理する部分を選ばせる手法だ。既存モデルは通常、すべてのトークンを各層で計算する。TokenGateは指定した層で文書の各トークンに重要度を付け、決めた数だけを残して上位層に送る。残らなかったトークンは、それ以降の層の計算と、その各層で作るキー・バリューキャッシュ、つまり以前の計算結果を保存して再利用するメモリから除外される。
従来のトークン選別方式は、学習せずにアテンションスコア、つまりトークン間の関連度を示す値などの規則でトークンを絞る。論文は、初期層のスコアだけを使う方法では、トークンを大幅に減らすと精度が低下したと説明する。TokenGateはモデルと選別器を追加学習によって一緒に微調整し、どのトークンを残すかを学ぶ。
2. 選別器とモデルを一緒に微調整
学習時にはトークンを選ぶスコアが上位層のアテンション計算にも影響するようにし、どの選択が正答に役立つかを学ばせる。全文脈と削減した文脈の学習結果を併せて反映するため、一度学習した選別器を複数のトークン予算で使える。
リポジトリの推論例は、文書の区間を示し、残すトークン数を指定する方式だ。以下はREADMEのコードから該当部分をそのまま抜粋した。
for k in (None, 2000, 500, 100):          # None = keep every state token
    out = model.generate([ids], tok, max_kept_prefill_tokens=k)
    print(k, f"{out.prefill_s * 1e3:5.0f} ms", out.answers[0])
3. 長文脈で遅延削減幅が拡大
論文はQwen3-1.7Bを16k長の針探しタスクで学習し、より長い文脈で評価した。針探しは、長い文書に埋め込まれた特定の事実を見つけて答えるタスクだ。
下表は、全文脈を処理する微調整モデルと精度をそろえた場合の結果だ。入力を処理して最初のトークンを出すまでの時間(TTFT)と最大メモリ使用量を比較した。
表:文脈長に応じたTokenGateの削減効果
条件:Qwen3-1.7B、bf16、16kの針探しタスクで学習、バッチサイズ1、A100 1枚、全文脈との比較
単位:倍
| 評価文脈長 | TTFT速度向上 | ピークメモリ削減 |
|---|---|---|
| 16k | 11.3 | 3.42 |
| 32k | 12.8 | 3.43 |
| 64k | 13.0 | 3.43 |
| 128k | 13.0 | 3.43 |
文脈が長いほど速度向上幅は大きくなり、メモリ削減は3.42~3.43倍でほぼ同じだった。論文は、ゲートより下の層がすべてのトークンを処理し、ピークメモリに影響するためだと分析している。
4. リポジトリのテストとタスク別の違い
リポジトリが公開した別のベンチマーク、つまり性能比較のための標準テストでは、H100 1枚、バッチサイズ1で、学習用とは分けておいたテストデータを測定した。下表の元モデルは学習前のモデルで、枝刈りなしはゲートとモデルをタスクに合わせて微調整した後、全トークンを残した精度の基準値だ。
K=2000は文書トークンを2000個残す設定だ。コード補完のスコアは正解コードとの類似度、医薬品反応抽出のスコアは漏れなく正確に抽出できたかを評価する。
表:リポジトリ公開のテスト結果
条件:Qwen3-1.7Bベース、H100 1枚、バッチサイズ1、学習用とは分離したテストデータ、K=2000
単位:TTFTは学習前の元モデルに対する倍率
| データセット | 標本数 | 指標 | 元モデル | 枝刈りなし | K=2000 | TTFT速度向上 |
|---|---|---|---|---|---|---|
| NIAH 針探し (16k) | 150 | 正答率 | 0.993 | 1.000 | 1.000 | 6.3 |
| RepoBench-P | 450 | 編集類似度 | 0.285 | 0.587 | 0.550 | 3.8 |
| BioDEX-Reactions | 450 | F1 | 0.056 | 0.284 | 0.292 | 2.1 |
コード補完では枝刈りなしの結果よりスコアが低かったが、医薬品反応抽出ではわずかに高かった。リポジトリの別の針探しデモでは、約32kの文書で100個のトークンだけを残しても5例すべてで答えを発見し、TTFT速度向上は11.18倍だった。これは5文書、針の位置11~100%、GPU 1枚という条件での結果だ。
5. 速度・メモリの利点と代償
論文は本実験で、全文脈の微調整モデルと精度をそろえた場合、プリフィルが1.4~11.3倍高速化し、ピークメモリが1.5~3.4分の1になったと報告した。Qwen3-1.7B、bf16、A100 1枚、バッチサイズ1で複数のタスクを評価した結果だ。論文5.1節で次に性能が良かった選別方式と比べ、速度向上は最大6.4倍、メモリ削減は最大2.1倍だった。
推論コストを節約する代わりに、選別器の学習と実行環境の準備にコストがかかる。論文付録のQwen3-1.7B、A100 1枚の実験では、学習の1ステップは標準的な微調整より1.3倍遅かったが、5タスクの総学習時間の平均は標準方式の0.8倍だった。
標準構成での高速実行にはCUDAカーネルのビルドが推奨され、推論はカーネルなしでも代替経路で実行できる。学習で代替経路を使うには、明示的に選ぶ必要がある。
精度の低下もタスクとトークン予算に応じて生じ、論文の要約例では出来事は正しく要約したものの、名前と場所を誤った。
TokenGateは長文脈のプリフィルを削減する実用的な選択肢を示すが、その効果は学習データとタスクに合わせたトークン選別に左右される。