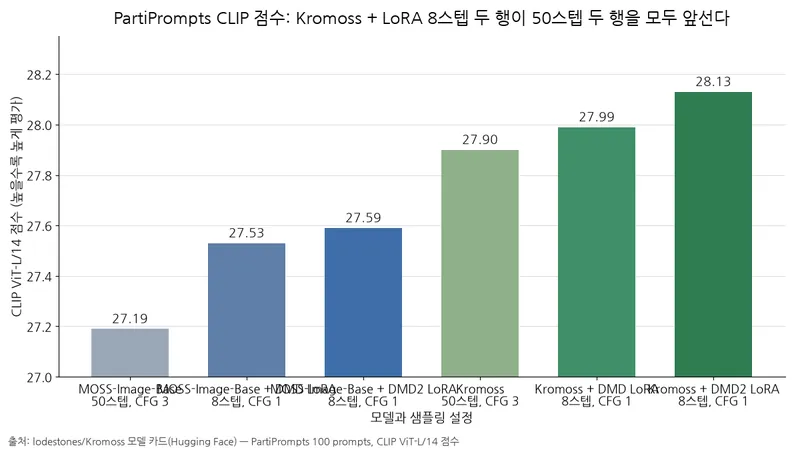
lodestones가 이미지 모델 Kromoss와 생성 단계를 50회에서 8회로 줄이는 어댑터 두 개를 Hugging Face에 공개했다. 제작자의 PartiPrompts 100프롬프트 측정에서 추천 어댑터를 쓴 8스텝 경로는 이미지와 프롬프트의 부합도를 보는 CLIP 점수 28.13점으로, 50스텝 Kromoss의 27.90점을 앞섰다. 차이는 0.23점이며, 베이스 모델의 50스텝 27.19점보다는 0.94점 높다. 생성 단계를 줄이면서도 이 채점 성능을 유지할 선택지가 생긴 셈이다.
측정 방법
이 비교는 같은 100개 프롬프트로 생성한 이미지의 프롬프트 부합도를 평가한 제작자 자체 측정이다. 50스텝 모델과 어댑터를 붙인 8스텝 모델은 프롬프트 반영 강도와 생성 경로도 다르다. 따라서 스텝만 바꾼 대조 실험이 아니라 두 생성 경로 전체의 비교로 읽어야 한다. 세부 설정은 아래 조건에 모았다.
두 어댑터는 작은 추가 행렬을 학습하는 LoRA 방식이다. 생성 단계를 줄이도록 학습한 DMD와 이를 더 학습한 DMD2로 나뉜다.
결과
표: PartiPrompts 100프롬프트 CLIP 점수 비교
조건: 제작자 모델 카드 표기 기준, PartiPrompts 100프롬프트, CLIP ViT-L/14 채점, Kromoss 행은 파인튜닝 update 11000의 EMA 가중치 기준, 50스텝 경로는 CFG 3·8스텝 경로는 CFG 1, 샘플러 flow-matching Euler·shift 5
| 설정군 | 모델 · 설정 | CLIP ViT-L/14 점수 |
|---|---|---|
| 50스텝·CFG 3 | MOSS-Image-Base, 50스텝, CFG 3 | 27.19 |
| 50스텝·CFG 3 | Kromoss, 50스텝, CFG 3 | 27.90 |
| 8스텝·CFG 1 + LoRA | MOSS-Image-Base + 8-steps-dmd-lora, 8스텝, CFG 1 | 27.53 |
| 8스텝·CFG 1 + LoRA | MOSS-Image-Base + 8-steps-dmd2-lora, 8스텝, CFG 1 | 27.59 |
| 8스텝·CFG 1 + LoRA | Kromoss + 8-steps-dmd-lora, 8스텝, CFG 1 | 27.99 |
| 8스텝·CFG 1 + LoRA | Kromoss + 8-steps-dmd2-lora, 8스텝, CFG 1 | 28.13 |
두 50스텝 행을 모두 앞선 것은 Kromoss에 LoRA를 얹은 두 8스텝 행뿐이다. 50스텝에서는 Kromoss가 베이스 모델보다 0.71점 높다. Kromoss에 LoRA를 붙인 8스텝 경로는 여기서 DMD가 0.09점, DMD2가 0.23점 더 높아, 모델 추가 학습에 따른 차이와 어댑터 경로의 차이를 나누어 볼 수 있다. DMD2 LoRA는 DMD LoRA보다도 미세하게 높다.
두 경로의 차이는 스텝과 CFG, 네거티브 브랜치, 원치 않는 요소를 억제하는 경로 처리 세 가지다. 스텝은 50에서 8로, CFG는 3에서 1로 내려가고, 네거티브 브랜치는 8스텝 경로에서 아예 사라진다. 50스텝 경로는 네거티브 브랜치에서 인덱스 22 레이어를 건너뛴다.
용량은 따로 계산한다. ComfyUI(노드형 이미지 생성 도구)용 단일 파일은 bf16(16비트 부동소수점) 기준 10.16 GB, int8(8비트 정수) ConvRot 기준 5.41 GB이고, 텍스트 인코더 qwen3.5_9b_bf16은 19.31 GB, 8스텝 LoRA는 각 1.19 GB다. 배포 파일 크기는 Hugging Face 파일 목록에서 확인한 값이다.
모델 학습과 8스텝 증류 방식
제작자가 공개한 모델 카드에 따르면 Kromoss는 1024 px에서 모든 트랜스포머 가중치를 추가 학습한 모델이다. 트랜스포머는 문맥 관계를 계산하는 신경망 구조이며, 가중치는 모델이 학습하는 수치 값이다. 학습 이미지는 704k장이다.
이 8스텝 프로젝트에서 DMD는 베이스 모델의 50스텝·CFG 3 경로를 8회의 네트워크 평가로 줄이는 데 쓰였다. 제작자의 MOSS-Image-Base 8스텝 증류 카드에 적힌 데이터 공간 DMD는 고정 노이즈에서 생성기가 노이즈를 제거한 이미지의 추정값을 반복해 만드는 방식이다.
DMD2 LoRA는 그 학습을 기존의 1/4 학습률로 3000회 더 이어가며, 실제 이미지를 상대로 판별기를 학습하는 GAN 단계를 추가한다. GAN은 생성기와 진짜·가짜를 구분하는 판별기를 겨루게 하는 학습 방식이다.
카드 기준으로 DMD2는 대비와 디테일이 조금 늘고 PartiPrompts 점수가 가장 좋다고 적혀 추천 LoRA로도 지목된다.
모델 카드에 따르면 두 LoRA는 베이스 모델에서 증류했지만 Kromoss로 전이된다. 같은 LoRA를 붙인 8스텝 행에서도 Kromoss가 베이스 모델 위에 선다.
이 격차는 100프롬프트 채점 기준의 값이어서, 다른 프롬프트 집합에서도 같은 크기로 재현된다는 보장은 없다.
고를 때 기준
스텝 수를 줄여야 한다면 8-steps-dmd2-lora.safetensors를 KSampler의 샘플러 euler·스케줄러 simple, 8스텝, CFG 1로 붙인다. 4스텝도 동작한다고 카드에 적혀 있다. 50스텝을 유지할 여유가 있다면 LoRA 없이 Kromoss 전체 모델만 쓰면 되고, 점수는 이 표의 기준선이 된다.
LoRA는 bf16 가중치에 병합하지 말고 diffusers에서는 병합하지 않은 상태로, ComfyUI에서는 strength 1로 붙인다. 제작자는 델타가 bf16 반올림 단위에 가까워 bf16 가중치에 병합하지 말라고 안내한다.
다음은 모델 카드에서 발췌한 호출 예제다. diffusers에서 DMD2 어댑터를 병합 없이 적용한 파이프라인 pipe, 입력 문장 prompt, torch가 이미 준비됐다는 전제다.
image = pipe(prompt, height=1024, width=1024, num_inference_steps=8, guidance_scale=1.0,
             generator=torch.Generator("cpu").manual_seed(42)).images[0]
그래픽 메모리인 VRAM이 빠듯하면 int8 ConvRot, 회전 변환을 적용해 가중치를 저장하는 방식 단일 파일을 쓴다. 블록 선형층, 입력을 선형 변환하는 신경망 층 168개를 int8로 저장하고, 가중치를 섞어 저장하는 256폭 Hadamard 회전, 값을 섞어도 크기를 보존하는 변환을 넣은 형태이며 ComfyUI가 로드 시점에 회전을 복원한다. 텍스트 인코더는 별도로 필요하다.
MOSS-Image-SFT를 쓰던 사람은 Kromoss를 대신 쓸 수 있다. 카드 기준으로 아키텍처와 텍스트 인코더, VAE, 이미지를 압축·복원하는 인코더, 저장소 레이아웃이 같아 파일만 바꿔 붙이면 된다.
체크포인트, 학습 상태를 저장한 파일은 자주 바뀐다. 이 저장소는 2026-10-19 공개 뒤 같은 날 학습 2000·5000·7000회, 다음 날 학습 9000·11000회 시점으로 갱신됐고, 2026-10-20에는 DMD2 LoRA가 추가됐다.
제작자의 PartiPrompts 100프롬프트 측정에서 Kromoss의 DMD2 LoRA 경로는 생성 단계를 50회에서 8회로 줄이고도 프롬프트 부합도 점수가 27.90점에서 28.13점으로 높았다.