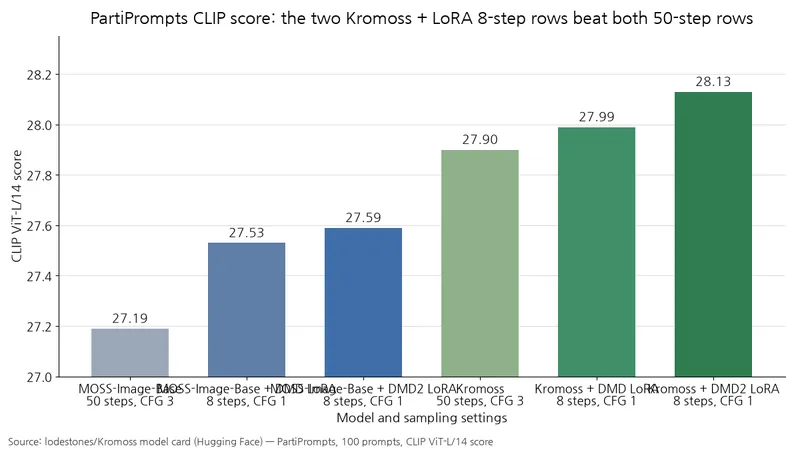
lodestonesが画像モデルKromossと、生成ステップを50回から8回に減らす2つのアダプターをHugging Faceで公開した。開発者によるPartiPromptsの100プロンプトでの測定では、推奨アダプターを使った8ステップ経路は、画像とプロンプトの一致度を示すCLIPスコアが28.13点で、50ステップのKromossの27.90点を上回った。差は0.23点で、ベースモデルの50ステップの27.19点よりは0.94点高い。生成ステップを減らしながら、この評価性能を維持する選択肢ができたことになる。
測定方法
この比較は、同じ100個のプロンプトで生成した画像のプロンプト一致度を評価した、開発者自身による測定である。50ステップモデルとアダプターを付けた8ステップモデルでは、プロンプトの反映強度と生成経路も異なる。したがって、ステップ数だけを変えた対照実験ではなく、2つの生成経路全体の比較として読む必要がある。詳細設定は以下の条件にまとめた。
2つのアダプターは、小さな追加行列を学習するLoRA方式を採用する。生成ステップを減らすよう学習したDMDと、それをさらに学習したDMD2に分かれる。
結果
表:PartiPromptsの100プロンプトでのCLIPスコア比較
条件:開発者のモデルカードの記載に基づく、PartiPromptsの100プロンプト、CLIP ViT-L/14で評価、Kromossの行は追加学習のupdate 11000のEMA重みを使用、50ステップ経路はCFG 3・8ステップ経路はCFG 1、サンプラーはflow-matching Euler・shift 5
| 設定群 | モデル・設定 | CLIP ViT-L/14スコア |
|---|---|---|
| 50ステップ・CFG 3 | MOSS-Image-Base, 50ステップ, CFG 3 | 27.19 |
| 50ステップ・CFG 3 | Kromoss, 50ステップ, CFG 3 | 27.90 |
| 8ステップ・CFG 1 + LoRA | MOSS-Image-Base + 8-steps-dmd-lora, 8ステップ, CFG 1 | 27.53 |
| 8ステップ・CFG 1 + LoRA | MOSS-Image-Base + 8-steps-dmd2-lora, 8ステップ, CFG 1 | 27.59 |
| 8ステップ・CFG 1 + LoRA | Kromoss + 8-steps-dmd-lora, 8ステップ, CFG 1 | 27.99 |
| 8ステップ・CFG 1 + LoRA | Kromoss + 8-steps-dmd2-lora, 8ステップ, CFG 1 | 28.13 |
50ステップの2行をともに上回ったのは、KromossにLoRAを載せた8ステップの2行だけである。50ステップでは、Kromossがベースモデルより0.71点高い。KromossにLoRAを付けた8ステップ経路は、そこからDMDが0.09点、DMD2が0.23点高く、モデルの追加学習による差とアダプター経路による差を分けて確認できる。DMD2 LoRAはDMD LoRAよりもわずかに高い。
2つの経路の違いは、ステップ数、CFG、そして望ましくない要素を抑える経路であるネガティブブランチの処理の3つである。ステップ数は50から8に、CFGは3から1に下がり、8ステップ経路ではネガティブブランチ自体がなくなる。50ステップ経路では、ネガティブブランチでインデックス22のレイヤーをスキップする。
容量は別に計算する。ComfyUI(ノード型の画像生成ツール)用の単一ファイルは、bf16(16ビット浮動小数点)で10.16 GB、int8(8ビット整数)ConvRotで5.41 GBであり、テキストエンコーダーqwen3.5_9b_bf16は19.31 GB、8ステップLoRAはそれぞれ1.19 GBである。配布ファイルのサイズはHugging Faceのファイル一覧で確認した値である。
モデルの学習と8ステップ蒸留の方式
開発者が公開したモデルカードによると、Kromossは1024 pxですべてのトランスフォーマー重みを追加学習したモデルである。トランスフォーマーは文脈の関係を計算するニューラルネットワーク構造で、重みはモデルが学習する数値である。学習画像は704k枚である。
この8ステッププロジェクトでは、ベースモデルの50ステップ・CFG 3経路を8回のネットワーク評価に減らすためにDMDが使われた。開発者のMOSS-Image-Baseの8ステップ蒸留カードに記載されたデータ空間DMDは、固定ノイズから生成器がノイズを除去した画像の推定値を繰り返し作る方式である。
DMD2 LoRAは、その学習を従来の1/4の学習率でさらに3000回続け、実画像を使って判別器を学習するGANの段階を追加する。GANは生成器と、本物・偽物を見分ける判別器を競わせる学習方式である。
カードにはDMD2はコントラストとディテールが少し増し、PartiPromptsスコアが最も良いと記載され、推奨LoRAにも挙げられている。
モデルカードによると、2つのLoRAはベースモデルから蒸留されたが、Kromossにも転用できる。同じLoRAを付けた8ステップの行でも、Kromossがベースモデルを上回る。
この差は100プロンプトでの評価に基づく値であり、別のプロンプト集合でも同じ大きさで再現される保証はない。
選択の基準
ステップ数を減らす必要があるなら、8-steps-dmd2-lora.safetensorsをKSamplerのサンプラーeuler・スケジューラーsimple、8ステップ、CFG 1で適用する。カードには4ステップでも動作すると記載されている。50ステップを維持する余裕があるなら、LoRAなしでKromossのフルモデルだけを使えばよく、そのスコアがこの表の基準となる。
LoRAはbf16重みにマージせず、diffusersではマージしない状態で、ComfyUIではstrength 1で適用する。開発者は、差分がbf16の丸め単位に近いため、bf16重みにマージしないよう案内している。
以下はモデルカードから抜粋した呼び出し例である。diffusersでDMD2アダプターをマージせずに適用したパイプラインpipe、入力文prompt、torchがすでに用意されていることを前提とする。
image = pipe(prompt, height=1024, width=1024, num_inference_steps=8, guidance_scale=1.0,
             generator=torch.Generator("cpu").manual_seed(42)).images[0]
グラフィックスメモリーのVRAMに余裕がなければ、回転変換を適用して重みを保存する方式のint8 ConvRot単一ファイルを使う。入力を線形変換するニューラルネットワーク層であるブロック線形層168個をint8で保存し、重みを混ぜて保存する256幅のHadamard回転を加えた形式である。この回転は値を混ぜても大きさを保つ変換で、ComfyUIが読み込み時に回転を復元する。テキストエンコーダーは別途必要である。
MOSS-Image-SFTの利用者は、代わりにKromossを使える。カードによると、アーキテクチャ、テキストエンコーダー、画像を圧縮・復元するエンコーダーであるVAE、リポジトリのレイアウトが同じなので、ファイルを差し替えるだけでよい。
学習状態を保存したファイルであるチェックポイントは、頻繁に変わる。このリポジトリは2026-10-19の公開後、同日に学習2000・5000・7000回、翌日に学習9000・11000回の時点へ更新され、2026-10-20にはDMD2 LoRAが追加された。
開発者によるPartiPromptsの100プロンプトでの測定では、KromossのDMD2 LoRA経路は生成ステップを50回から8回に減らしても、プロンプト一致度のスコアが27.90点から28.13点に上昇した。