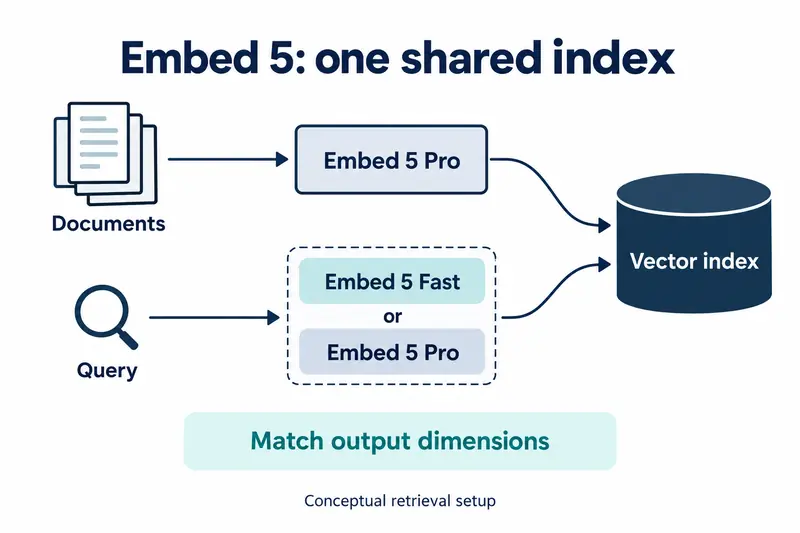
Cohere가 9월 30일 Embed 5를 출시했다. 모델 ID는 embed-v5.0-pro와 embed-v5.0-fast다.
릴리스 노트는 두 모델이 임베딩 공간을 공유한다고 설명한다. 한 모델로 인덱싱한 문서 모음을 다른 모델로 쿼리할 수 있다는 뜻이다.
그래서 문서를 임베딩하는 모델과 쿼리를 임베딩하는 모델을 따로 고를 수 있다. Cohere는 인덱싱에 Pro, 쿼리에 Fast를 권장한다.
출력 차원과 입력 유형으로 정해지는 벡터 호환 조건
출시 발표에는 조건이 붙는다. 문서 벡터와 쿼리 벡터의 출력 차원이 같아야 한다.
벡터를 짧게 자르는 Matryoshka 절단과, 값을 더 낮은 정밀도로 저장하는 int8 양자화를 적용해도 호환성은 유지된다고 Cohere는 설명한다. 이는 벡터 표현의 호환성 설명이지 검색 결과가 같다는 뜻은 아니다.
임베딩 문서는 검색 대상 텍스트에 input_type="search_document"를, 검색 쿼리에 input_type="search_query"를 지정하라고 안내한다. 벡터 길이는 output_dimension 매개변수로 고른다.
모델을 비교할 때 이 설정들이 기록되지 않으면, 차이가 모델에서 왔는지 설정에서 왔는지 가릴 수 없다.
주의할 점: Embed 4 인덱스와 자체 평가 수치
공유 공간에 대한 호환성 설명은 두 Embed 5 모델 사이의 것이다. 이전 Embed 4 인덱스를 그대로 쓸 수 있다는 근거는 아니다.
Cohere는 40개 개발용 데이터셋에서 교차 조합을 시험했고, Fast 쿼리와 Pro 쿼리의 평균 손실이 각각 1.6%, 2.7%였다고 밝혔다.
이 수치는 Cohere 자체 평가다. 호환성만으로 특정 문서 모음에서의 검색 품질을 입증하기에는 부족하다.
조건을 고정한 쿼리 측 비교
다음 단계는 조건을 통제한 쿼리 측 비교다. Pro로 인덱싱한 문서, 출력 차원, 벡터 형식, 검색 설정, 대표 쿼리를 고정한 뒤 Fast와 Pro의 검색 관련성과 종단 간 지연 시간을 비교한다.
애플리케이션에 중요한 언어와 분야의 까다로운 쿼리도 함께 넣는다.
Fast가 요구 사항을 채운다면 문서에 명시된 공유 공간 덕분에 문서 벡터를 다시 만들지 않고 쿼리 경로만 바꿀 수 있다. 이는 평가 계획이며 이 기사를 위해 실제로 수행한 테스트는 아니다.
같은 공간을 공유한다는 보장은 인덱스 재구축을 덜어 줄 뿐, 자기 쿼리에서의 검색 품질은 따로 재야 하는 값이다.