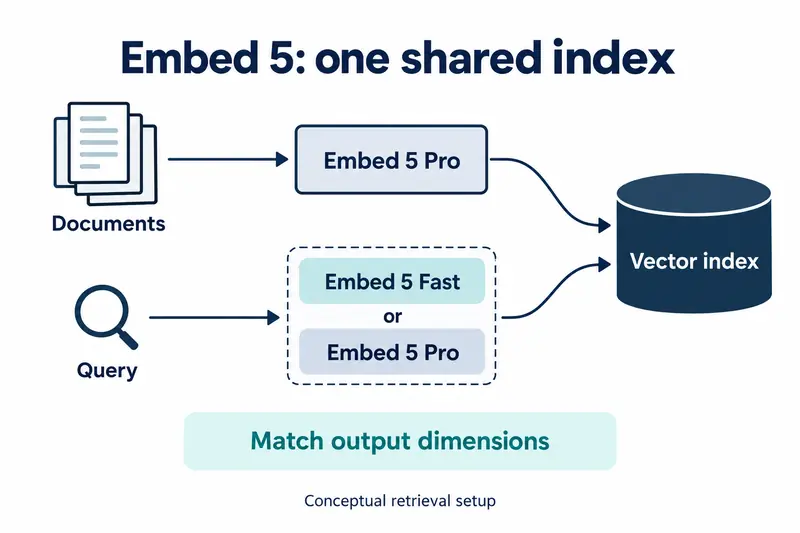
Cohere 于9月30日发布 Embed 5,模型 ID 为 embed-v5.0-pro 和 embed-v5.0-fast。
发布说明指出,两个模型共享嵌入空间。用一个模型索引的文档集合,可以用另一个模型查询。
因此,嵌入文档的模型和嵌入查询的模型可以分别选择。Cohere 推荐用 Pro 建索引、用 Fast 查询。
由输出维度和输入类型决定的向量兼容条件
发布公告附有条件:文档向量与查询向量的输出维度必须相同。
Cohere 表示,使用缩短向量的 Matryoshka 截断,以及以更低精度存储数值的 int8 量化,兼容性同样成立。这说明的是向量表示的兼容性,而不是检索结果相同。
嵌入文档要求对被检索的文本设置 input_type="search_document",对检索查询设置 input_type="search_query"。向量长度通过 output_dimension 参数选择。
比较模型时如果不记录这些设置,就无法分辨差异来自模型还是来自设置。
注意事项:Embed 4 索引与自有评估数据
关于共享空间的兼容性说明针对的是两个 Embed 5 模型,并不能证明之前的 Embed 4 索引可以直接复用。
Cohere 称在40个开发数据集上测试了交叉组合,Fast 查询和 Pro 查询的平均损失分别为1.6%和2.7%。
这些是 Cohere 的自有数据。仅凭兼容性,不足以证明在特定文档集合上的检索质量。
固定条件下的查询端比较
下一步是控制条件的查询端比较。固定用 Pro 索引的文档、输出维度、向量格式、检索设置和代表性查询,然后比较 Fast 与 Pro 的检索相关性和端到端延迟。
同时加入对应用重要的语言和领域中的难查询。
如果 Fast 满足需求,借助文档中写明的共享空间,无需重新生成文档向量即可只切换查询路径。这是评估计划,并非为本文实际进行的测试。
共享空间的保证省去了索引重建,但在自己查询上的检索质量仍是需要单独测量的数值。