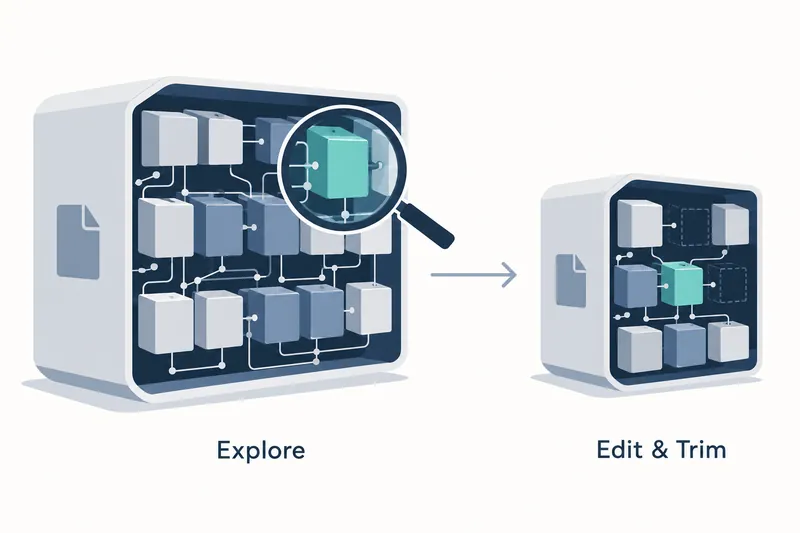
ローカル言語モデルの内部構造を目で確認し、一部を編集・削減した新しいファイルを作るツール、NeuronDumpが公開された。開発者はモデルのどの部分を変えると出力が変わるかを元のモデルと並べて試し、容量削減の候補を探せる。
1. モデル構造の確認から新しいファイルの保存まで
開発者aymen94が10月26日に紹介したNeuronDump 0.1.3は、コマンドラインツールとローカルWeb画面を1つの実行ファイルにまとめている。ローカルモデルの保存形式であるGGUFを直接読み取り、画面の構成要素も内蔵するためオフラインで使える。
グラフはモデルを層ごとの設計図のように展開して表示する。重みを格納する配列であるテンソルや、数値を低精度で保存する方式である量子化形式、語彙、チャットテンプレートを確認できる。層を開くと、入力の関係を見るヘッドや、計算単位であるニューロンのまとまりまで掘り下げられる。
構造分析とファイルサイズの算出は、モデルを実行せずファイルを読み取って処理する。ソースやパッケージからインストールする際に実行追跡機能を選ぶと、CPUでモデルを動かし、編集前後のトークンと確率を比較できる。
簡単な利用の流れは次のとおりだ。以下のコマンドはリポジトリのREADMEにある例だ。
neurondump list                          # every local model
neurondump inspect llama3.2:1b           # what's inside a model
neurondump vocab llama3.2:1b --search hello
neurondump template llama3.2:1b          # the chat template as a tree
neurondump analyze llama3.2:1b --out plan.json
neurondump slim llama3.2:1b --plan plan.json --only vocab --out small.gguf
neurondump tokens llama3.2:1b "fn main() {" --chat     # tokens, template tokens, nearest tokens
neurondump web --open                    # the same, in your browser
2. 同じ構造でも予測が変わる箇所を探す
リポジトリのQwen3 8BとDeepSeek R1 0528 Qwen3 8Bの比較では、399個のテンソルの名前・形状・型は同じだったが、バイト単位で一致するテンソルはなかった。リポジトリでは、新しい層を追加したのではなく、重み全体を微調整した結果と解釈している。
地球が周回する恒星の名前を問う未完成の英文を入力すると、両モデルとも29番の層で太陽を意味する予測が初めて現れた。層ごとの中間状態を次のトークン候補として読み取った追跡結果であり、以下の確率はリポジトリに記録された値だ。
表:同じ入力で層ごとに現れた予測確率
条件:NeuronDump 0.1.3、candle、CPU、両モデルともQ4_K_M、地球が周回する恒星の名前を問う同一入力9トークン
| 予測箇所と対象 | Qwen3 8B | DeepSeek R1 8B |
|---|---|---|
| 30番の層の中国語の太陽トークン | 0.91 | 0.94 |
| 最終層の英語の定冠詞トークン | 0.45 | 0.35 |
中間層で答えが現れた後、最後には英語の定冠詞を選んだ流れを、リポジトリでは事実を探す段階と表現を選ぶ段階と解釈している。開発者は最終出力だけでなく、どの層で候補が変わるかを調べ、その部分の編集効果を比較できる。
3. 容量削減と品質の変化を併せて評価する
リポジトリのllama3.2:1bの試験計画では、サンプルコーパスを使って語彙を570個に減らした結果、ファイルサイズが1.23 GiBから987 MiBへ21.6%減少した。GGUFの検証では147個のテンソルと16個の層が確認された。語彙を減らすと、出力に使えるトークンの範囲も狭まる。
層の削除による効果は、決められた評価文の集合であるコーパスで比較した。以下のperplexityは、モデルがそれらの文を予測する難しさを示し、低いほどよい。
表:層の削除によるperplexity
条件:candle、CPU、llama3.2:1b、同一の英語評価文5本からなるコーパス
| 削除した層 | 元のモデル | 削除後 |
|---|---|---|
| 7番の層 | 7.554 | 10.915 |
| 15番の層 | 7.554 | 15.976 |
| 0番の層 | 7.554 | 23257.776 |
この評価では、中間層よりも最初や最後の層を削除したときに予測品質が大きく低下した。容量削減の利益と引き換えになるのは、出力品質と探索時間だ。試験計画書で層を1つずつ除外して評価した探索は、5個のサンプルの96か所を対象にモデル計算を85回行い、CPUで約4分かかった。
編集は元のファイルに手を加えず、メモリ上で比較した後、新しいファイルに保存する流れだ。開発者は削除候補を選び、使用予定の文で品質を評価してから縮小ファイルを作れる。
4. 実行の対応範囲に合わせて実験対象を選ぶ
実行実験は対応一覧にあるモデル系列のCPU処理に限られる。エキスパートを選んで計算するMoEや、異なる層方式を組み合わせたハイブリッドモデルの実行、およびヘッド・ニューロン・エキスパートをファイルから切り取る縮小には対応しない。
リポジトリでは初期バージョンと位置づけており、新しい3次元データフロー画面とトークン・編集画面は、文書上ではまだブラウザでの実行検証を行っていない。
NeuronDumpの価値はモデルを小さくする機能だけでなく、構造と出力の変化を併せて見ながら、何を削減するかを決められる点にある。