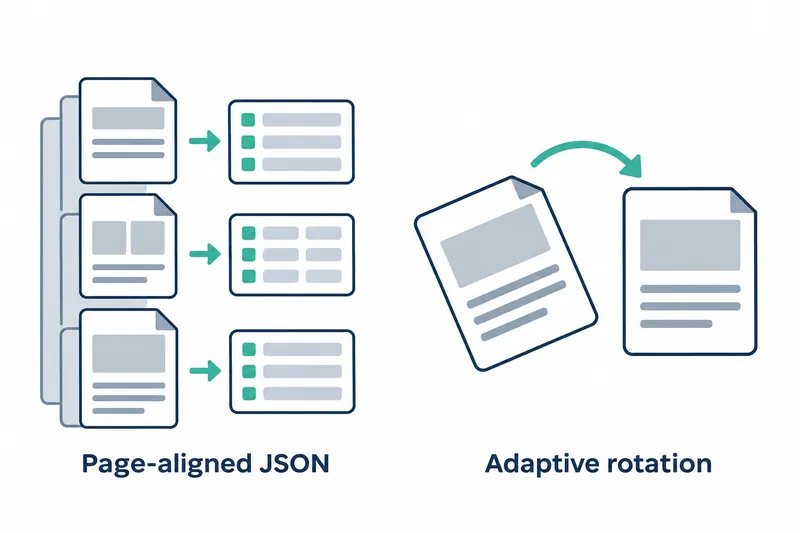
MiniCPM-OCR開発ツールの新バージョンは、文書の認識結果をページ別に保存し、画像の向き補正をデフォルトで有効にした。文書処理機能を作る開発者は、ローカルの結果とオンライン応答を同じ構造で扱い、傾いた入力を補正する工程を標準の処理フローに組み込める。
1. ページの結果をオンライン応答の構造に合わせる
v1.0.4は2026年11月3日に公開された。各ページのJSONファイルがpages_json/<image_id>.jsonにも記録される。構造はオンライン文書解析APIの単一ページ応答と一致するように整えられた。
応答にはページ番号、認識した内容、文書内の認識領域であるブロックの一覧、回転情報、使用量が含まれる。ローカルに保存したファイルとオンライン応答の項目がそろうため、後続プログラムでは結果を読み込む仕組みを共通化しやすくなる。
2. ページ別の結果を文書全体にまとめる
ファイルを指定してJSONを得るコマンドと、ページ別の結果を組み立てる関数が追加された。リリースノートによると、これらが生成する全体の結果は、リクエスト後に結果を受け取るオンライン非同期ジョブの結果と同じ構造にそろえられた。ページ別の保存に加え、文書全体をまとめて扱える出力も提供する変更だ。
minicpmvocr parse --json FILE
assemble_document_json()
1行目は指定したファイルを処理するコマンドで、2行目は組み立て用の関数名だ。ページを1枚ずつ渡す処理には個別ファイルを使い、文書全体を渡す処理には組み立てた結果を使う形で、後処理を構成できる。
3. ブロックの状態と回転履歴を一貫して残す
ブロックの状態値は4種類に統一された。認識に失敗した場合も、切り出した画像領域がない場合もfailedと表示し、具体的な理由は実行ログに残す。印章認識を無効にすると、印章ブロックはskipped_sealと記録される。
後続プログラムでは状態値から失敗した領域を見つけ、運用担当者はログで原因を絞り込める。失敗の表示と詳しい原因を、それぞれ別の場所で読み取る役割分担になっている。
回転情報はocr.rotationに記録され、オンライン応答のフィールドと同じ基準に従う。ページ別の結果で認識領域の状態と向き補正の履歴を一緒に読めるため、次の段階で認識結果を整える後処理でも、確認先が一定になる。
4. 自動の向き補正は利便性と実行コストをともに変える
向き補正はデフォルトで有効になり、クイックスタートではPaddleの向き補正モデル3個を自動でダウンロードする。回転機能を別途有効にしてモデルを準備する手間が減る一方、実行環境にはモデルのダウンロードと向き補正の工程が加わる。
画像が小さい場合は回転をスキップし、paddleocrがない場合は回転情報を利用できない。このモジュールがインストールされていない場合、エラーで停止せず、警告を残して向き補正を省略する。
5. 評価を再現する際は回転設定を明示する
既存の評価を継続する開発者は、入力の向きをそのままにするか、自動で補正するかを先に決められる。リリースノートは、OmniDocBenchのスコアを再現する際に向き補正を無効にすることを推奨している。回転しない結果が必要な処理フローでも、次の設定で補正を無効にできる。
--set upright.enabled=false自動補正を使う処理ではモデルの準備と補正工程を実行環境に織り込み、評価を再現する処理では推奨設定を適用する。出力構造をそろえる変更と、入力の向きを変えるデフォルト動作を、それぞれ後処理と実行設定に反映すればよい。
v1.0.4の実質的な変化は、ページ別の結果を連携させやすくすると同時に、向き補正を標準の処理工程に組み込んだ点にある。