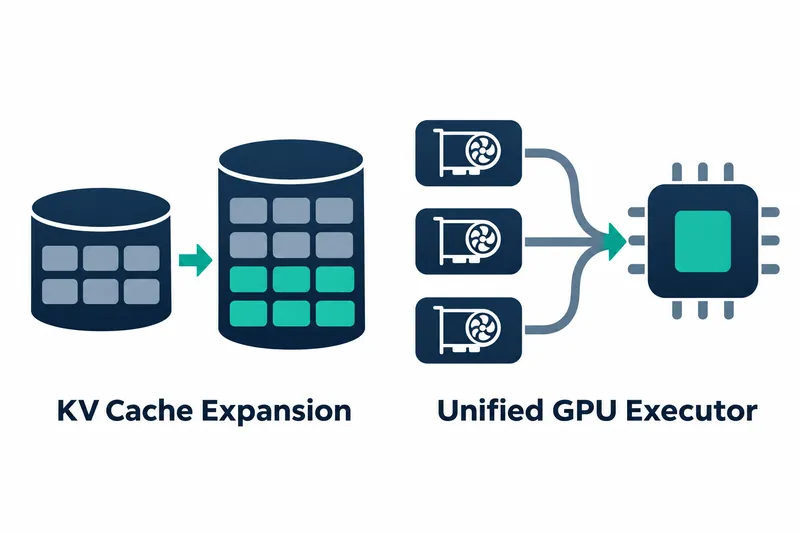
大语言模型推理引擎 vLLM 发布了新版本,默认启用缓存扩展以更充分利用空闲 GPU 内存,并统一了 GPU 上的模型执行路径。开发模型服务的人员可获得更多并发请求处理空间,部署时需要管理的执行器选项也随之减少。
1. 根据实际空闲内存而非估算值扩展缓存
新方式会在 CUDA 和 ROCm 上完成运行前预热及预先记录 GPU 执行顺序的图捕获后,根据实际空闲内存确定缓存大小。也就是说,从估算用量并预留空间,改为在准备完成后测量剩余空间。
据 vLLM 项目公布,H200 上 MiniMax-M3 的缓存从 43万3千个 token 扩大至 67万2千个 token。项目方解释,更大的缓存在并发请求较多时能提高吞吐量,即单位时间内处理的工作量,并降低首 token 延迟。
启用扩展缓存且用户未单独指定数值时,GPU 内存利用率默认值为 1.0。也可选择保留原有缓存计算方式,相关选项汇总在下方的升级部分。
2. GPU 执行器统一为第二版
vLLM 0.34.0 移除了在 GPU 上运行模型的第一版 Model Runner,仅保留第二版。让部署配置适配新执行器,是此次升级的关键工作。
用于调整下一输出候选项分数的原有 logits 处理器代码,需要迁移至 vllm.v1.worker.gpu.sample.logits_processor。
让两批任务重叠执行的功能也能在新执行器中运行。它还可与提前提出后续输出的推测解码搭配使用,因此执行器统一后仍可使用这一组合。
3. 面向长输入和输出生成的硬件专项改进
生成输出 token 的解码阶段也得到改进。据 vLLM 项目公布,在 4 个 GB200 上通过 TRTLLM-Gen 运行 Step5 时,解码速度最高为原来的 1.95倍。该数值针对在 TRTLLM-Gen 上运行 Step5 的 NVFP4 MoE 配置。
据项目公布,在英伟达环境中,应用于 GLM-5.3-Flash 的专家模型计算路径 DeepGEMM FP8 MegaMoE,输出吞吐量为对比路径 DEP4 的 1.6倍。
针对长输入,选择性引用所需部分并按 token 划分输入处理任务的路径得到改进。在将模型计算分配到多个 GPU 的张量并行运行中,输入处理 token 数达到 1024 个及以上时默认启用。
据项目公布,在 GB200 上以张量并行运行 GLM-5.3 并处理长度为 32K~128K 的提示词时,首 token 响应速度提升至原来的 1.24~1.40倍。
另有需单独启用的输出优化。据项目公布,在 GB300 上,均衡分配 Kimi-K3 缓存任务并引用输入信息的注意力路径,其解码注意力性能提升至原来的 1.34~1.59倍。
据项目公布,Muse Spark Open 的可选专用路径在 GB300 上的单流解码速度为原来的 1.5倍。
据项目公布,英伟达环境中的 Qwen3.5 无需 torch.compile,使用可中断 CUDA 图后,输出 token 间延迟降低了 3.0~8.8%。
AMD 方面,据项目公布,使用 8 个 MI355X 运行 Muse Spark Open,搭配 DSpark 推测解码并应用将输出生成计算合并执行的优化后,在 1~8 个并发请求下,交互指标改善了 35~57%。
4. 选择保留默认值还是沿用原有设置
缓存划分的默认块大小从 16 改为 64。指定了首选大小的后端优先使用自身数值,而 ROCm 的分页注意力,即按块管理内存的方式,仍使用 16。用户显式指定的块大小也会优先应用。
发行说明中的默认 CUDA 安装命令如下。
pip install vllm如需保留原有缓存计算方式,可在运行配置中将内存利用率设为 0.9,或选择关闭扩展缓存。下面前两行分别对应这两种选择,最后一行是指定旧版块大小的独立选项。
--gpu-memory-utilization 0.9
--no-enable-extensible-kv-cache
--block-size 16
AMD 发行包改用适用于 ROCm 10.0 的 wheel 安装包和镜像,不再使用 ROCm 7.2 版本。
5. 综合评估并发收益与部署前检查
为缓存分配更多内存的收益在于,可容纳更多请求。代价是,据 vLLM 项目公布,部分 H200 模型在 128 个并发请求条件下,每 token 解码延迟可能增加 6~18%。
部署前还需移除选择旧执行器的环境变量设置。若保留 VLLM_USE_V2_MODEL_RUNNER=0,将在启动阶段失败。
评估服务时,应同时关注并发接收的请求数及每个请求的输出间隔。对于长输入服务,宜重点查看首 token 响应改善;对于持续生成长输出的服务,则宜围绕生成速度与延迟变化解读相应硬件的结果。
vLLM 0.34.0 的核心是利用实际空闲内存扩展缓存,运维人员应综合考虑并发吞吐量收益与解码延迟变化,选择合适配置。