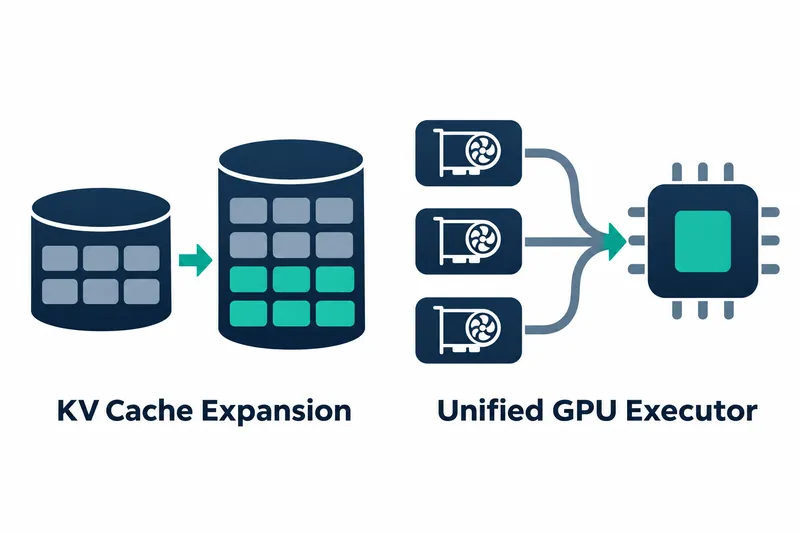
大規模言語モデルの推論エンジンvLLMが、GPUの空きメモリをさらに活用するキャッシュ拡張を標準で有効にし、GPUでモデルを実行する経路を一本化した新バージョンを公開した。モデルサービスを作る開発者は複数のリクエストを同時に処理する余裕を得られ、デプロイ時に管理する実行器の選択肢も減る。
1. 推定ではなく実際の空きメモリでキャッシュを拡張
新方式はCUDAとROCmで実行前の準備を行うウォームアップと、GPUの実行順序を事前に記録するグラフキャプチャを終えた後、実際の空きメモリに基づいてキャッシュサイズを決める。使用量を推定して領域を残す方式から、準備完了後の空き領域を測る方式に変わったことになる。
vLLMプロジェクトの発表によると、H200のMiniMax-M3のキャッシュは43万3千トークンから67万2千トークンに拡大した。プロジェクトは、大きなキャッシュが同時リクエストの多い状況でスループット、つまり単位時間当たりの処理量を高め、最初のトークンの遅延を減らすと説明した。
拡張キャッシュが有効で、ユーザーが値を個別に指定していない場合、GPUメモリ使用率のデフォルト値は1.0となる。従来のキャッシュ算定を維持する選択肢もあり、適用するオプションは下記のアップグレード項目にまとめた。
2. GPU実行器を第2世代に一本化
vLLM 0.34.0ではGPUでモデルを動かすModel Runnerの第1世代が削除され、第2世代だけが残った。デプロイ設定を新しい実行器に合わせることが、今回のアップグレードの主要な作業となる。
次の出力候補のスコアを調整する既存のロジットプロセッサのコードは、vllm.v1.worker.gpu.sample.logits_processorへ移す必要がある。
2つの作業バッチの実行を重ねる機能も、新しい実行器で動作する。次の出力を先に提案する投機的デコーディングとも併用でき、実行器の統合後もこの組み合わせを活用できる。
3. 長い入力と出力生成に向けたハードウェア別の改善
出力トークンを生成するデコード段階も改善された。vLLMプロジェクトの発表によると、GB200 4基でTRTLLM-Genを使って実行したStep5のデコード速度は最大1.95倍だった。この数値はStep5のNVFP4 MoEをTRTLLM-Genで実行した構成について発表されたものだ。
NVIDIA環境のGLM-5.3-Flashに適用したエキスパートモデルの演算経路であるDeepGEMM FP8 MegaMoEは、プロジェクトの発表によると、比較対象の経路DEP4に対して出力スループットが1.6倍だった。
長い入力では必要な部分を選んで参照し、入力処理の作業をトークン単位に分ける経路が改善された。モデルの演算を複数のGPUに分けるテンソル並列実行では、入力処理トークンが1024個以上の場合に標準で適用される。
プロジェクトの発表によると、GB200でGLM-5.3をテンソル並列で実行し、32K~128Kの長さのプロンプトを処理した場合、最初のトークンの応答が1.24~1.40倍速くなった。
個別に有効にする出力最適化もある。プロジェクトの発表によると、GB300でKimi-K3のキャッシュ作業を均等に分散しながら入力情報を参照するアテンション経路は、デコードアテンションの性能が1.34~1.59倍に改善された。
プロジェクトの発表によると、Muse Spark Openの選択式の特化経路は、GB300でシングルストリームのデコード速度が1.5倍だった。
プロジェクトの発表によると、NVIDIA環境のQwen3.5は、torch.compileなしで中断可能なCUDAグラフを使うことで、出力トークン間の遅延が3.0~8.8%低下した。
AMD側ではプロジェクトの発表によると、MI355X 8基でMuse Spark OpenをDSpark投機的デコーディングとともに実行し、出力生成の演算を一括する最適化を適用した場合、同時リクエスト1~8件で対話性の指標が35~57%改善した。
4. デフォルトを維持するか従来の設定を使うか選択
キャッシュを分割する標準ブロックサイズは16から64に変わった。推奨サイズを指定したバックエンドは独自の値を優先し、ブロック単位でメモリを管理する方式であるROCmのページングアテンションは引き続き16を使う。ユーザーが明示したブロックサイズも優先される。
リリースノートに記載された標準のCUDAインストールコマンドは次のとおりだ。
pip install vllm従来のキャッシュ算定を維持するには、実行設定でメモリ使用率を0.9に指定するか、拡張キャッシュを無効にするオプションのどちらかを選ぶ。下記の最初の2行がそれぞれの選択肢で、最後の行は以前のブロックサイズを指定する別のオプションだ。
--gpu-memory-utilization 0.9
--no-enable-extensible-kv-cache
--block-size 16
AMD向け配布物は、ROCm 7.2ではなく10.0向けの配布用インストールパッケージであるwheelとイメージを使う。
5. 同時処理の利点とデプロイ前の点検を併せて判断
キャッシュにより多くのメモリを割り当てる利点は、複数のリクエストを受け入れる領域が広がることだ。その代わり、vLLMプロジェクトの発表によると、一部のH200上のモデルでは同時リクエスト128件の条件で、トークン当たりのデコード遅延が6~18%増える可能性がある。
デプロイ前には、以前の実行器を選択する環境変数の設定も削除する必要がある。VLLM_USE_V2_MODEL_RUNNER=0を残すと、起動段階で失敗する。
サービスを評価する際は、同時に受け入れるリクエスト数と各リクエストの出力間隔を併せて確認する必要がある。入力が長いサービスなら最初のトークンの応答改善を、出力を長く生成するサービスなら生成速度と遅延の変化を中心に、該当するハードウェアの結果を読むのが有用だ。
vLLM 0.34.0の要点は実際の空きメモリを活用するキャッシュ拡張であり、運用者は同時処理量の利点とデコード遅延の変化を併せて見て設定を選ぶ必要がある。