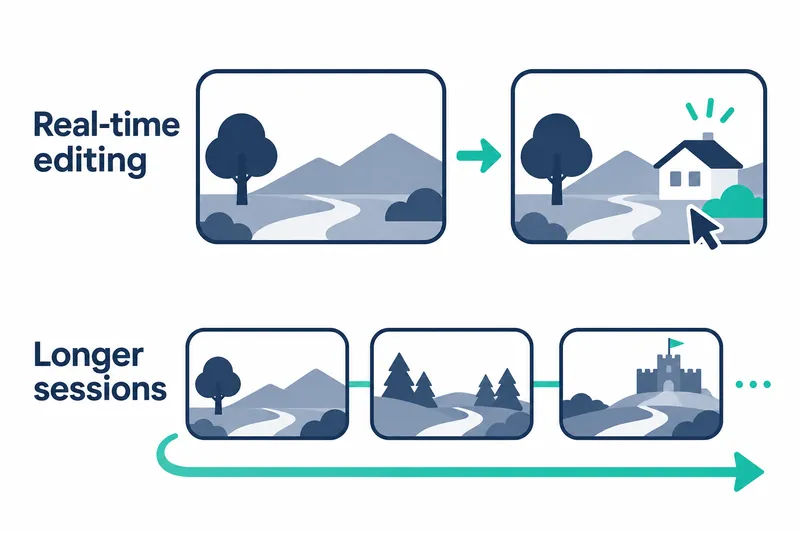
Google DeepMind 在 11 月 18 日的产品公告中表示,Project Genie 已引入全新世界模型 Genie 4,这是一种生成虚拟空间变化的 AI。用户可用文字实时编辑正在探索的场景,并生成与世界相符的声音。
1. 在探索中改变世界并聆听声音
在 Genie 4 中,用户可在世界中移动时用自然语言改变天气、添加人物和物体,并调整场景的发展方向。10 月 27 日的研究介绍称,输入的请求会结合周围场景得到落实。Gemini 会持续观察场景,将目标拆分为多个步骤,再检查 Genie 4 生成的画面,确认进展和各步骤是否成功。世界发生变化或用户介入时,它会相应调整计划。这不再只是像以往那样在开始时设定提示词,而是在探索中不断修改接下来的场景。
声音也会与世界一起生成,无须单独编辑。Google DeepMind 将 Genie 4 介绍为旗下首个直接生成实时音频的世界模型。林间风声、海滩浪声等环境音会随场景出现,人物对话则会响应用户输入或世界内的事件而变化。
2. Genie 3 侧重长时间探索和全景图
Genie 4 侧重视觉保真度,即与真实外观的接近程度,以及物理表现、物体运动的呈现方式和音频;Genie 3 则负责较长时间的探索或从全景图像开始的任务。如果需要更长的探索,或以将宽阔视野收于一张图中的全景图作为起点,可在 Project Genie 的模型选择界面使用 Genie 3。
根据 11 月 18 日的产品公告,Genie 3 将每次生成后的探索时间从原来的 60 秒延长至最长 3 分钟(180 秒)。这意味着每次生成的探索时长上限变为 3 倍,并不表示生成速度或性能提升至 3 倍。用户可用 360 度全景图像开启新世界,也可在探索中通过新增的自然语言提示词功能改变环境。
还可以连接多个世界,将森林、海底遗迹和冰海串成一段连续旅程。对于想更长时间查看已创建空间,或连接不同空间进行探索的用户,这是一个合适的选项。
3. 对话式创作与分享改变制作流程
11 月 18 日的产品公告介绍了全新的 Project Genie 智能体,即协调执行多项任务的 AI。用户用自然语言描述构想后,它会协调处理图像和声音的多个模型,制作初始画面,并添加符合氛围的背景音乐。创作者不必像以往那样将所有结果交给一条提示词,而是可以通过对话细化构想,构建世界。
探索时可调用 Gemini 模型,让它观察画面并建议下一个目的地,或自动触发与旅程相符的事件。
在新的社区画廊中,用户可以查看他人创建的世界,并修改现有作品的世界结构、背景音乐和规则,制作自己的版本。完成的世界也可发布到画廊,让其他用户探索并再次修改。将个人照片变为可漫步空间的体验也在此提供。
4. 创作试验加快,审查负担仍在
10 月 27 日的研究介绍中的试用用户正将 Genie 4 用作快速测试创作草案的工具。电影制作人通过改变镜头角度、灯光和台词试验不同场景,摄影记者则探索根据纪实照片重建环境的方法。谷歌表示,游戏开发者在编写游戏引擎代码前,会探索创意,并将其制作成可观察运行效果的初步原型进行测试。
初期可视化和迭代制作加快的同时,创作者也需要审查生成场景的物理与空间表现,以及前后场景是否一致。谷歌在 10 月 27 日的研究介绍中表示,Genie 4 处于正式发布前供测试的研究预览阶段。长时间探索或复杂编辑时,视觉细节和物体的保持情况可能发生变化。复杂物理交互、声音与文字表现、空间准确性和长期一致性,即内容随时间保持不变的程度,仍在研究中。
5. 先向符合条件的 Ultra 用户开放
根据 11 月 18 日的产品公告,Project Genie 的新体验自 2026 年 11 月 18 日起向符合条件的 Google AI Ultra 订阅用户逐步开放。Google AI Pro 用户可在同一页面加入候补名单。此前 10 月 27 日发布的研究介绍还介绍了面向 Gemini API 和 Google AI Studio 抢先体验合作伙伴的开放计划。
谷歌在 11 月 18 日的产品公告中表示,会在生成的视频和音频中加入用于识别来源的 SynthID 水印,并对模型输入和输出实施安全检查。通过在生成内容中加入识别标记,为世界的公开与再创作分享流程提供支持。
本次更新的核心不仅是更逼真的场景,还在于让用户按目的选择模型,在探索中修改世界,并延续他人的创作。