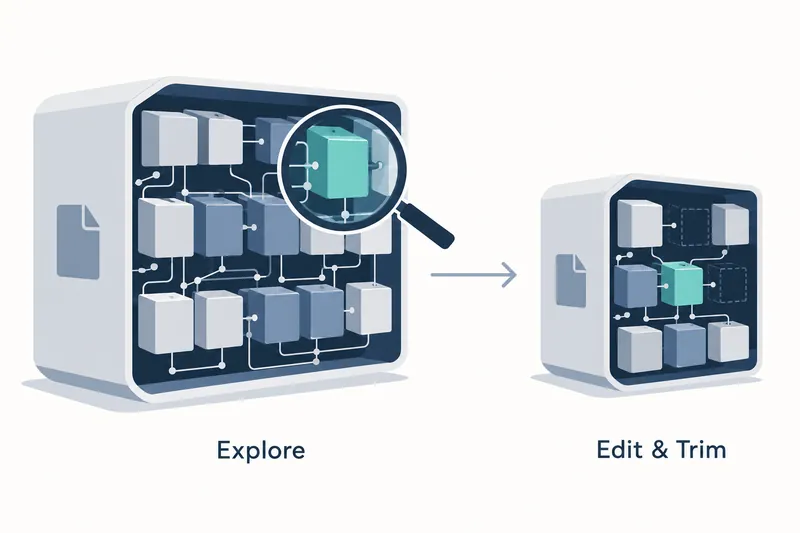
NeuronDump 已发布,这款工具可直观查看本地语言模型的内部结构,并创建经过部分编辑或精简的新文件。开发者可以将修改后的模型与原模型并排测试,观察改动哪些部分会影响输出,从而寻找可精简的候选部分。
1. 从查看模型结构到保存新文件
开发者 aymen94 于 10月26日介绍的 NeuronDump 0.1.3 将命令行工具与本地网页界面集成在一个可执行文件中。它直接读取本地模型存储格式 GGUF,并内置界面组件,可离线使用。
图形界面将模型像逐层设计图一样展开。用户可以查看存储权重的数组即张量、以较低精度存储数值的量化格式、词表和聊天模板,也可展开各层,深入查看关注输入关系的注意力头以及作为计算单元的神经元组。
结构分析和文件大小计算通过读取文件完成,无需运行模型。从源码或软件包安装时,若选择执行追踪功能,就可在 CPU 上运行模型,比较编辑前后的 token 和概率。
简单的使用流程如下。以下命令来自仓库 README 的示例。
neurondump list                          # every local model
neurondump inspect llama3.2:1b           # what's inside a model
neurondump vocab llama3.2:1b --search hello
neurondump template llama3.2:1b          # the chat template as a tree
neurondump analyze llama3.2:1b --out plan.json
neurondump slim llama3.2:1b --plan plan.json --only vocab --out small.gguf
neurondump tokens llama3.2:1b "fn main() {" --chat     # tokens, template tokens, nearest tokens
neurondump web --open                    # the same, in your browser
2. 找出相同结构下预测发生变化的位置
仓库对 Qwen3 8B 与 DeepSeek R1 0528 Qwen3 8B 的比较显示,399 个张量的名称、形状和类型相同,但没有任何张量在字节层面完全一致。仓库将其解释为对全部权重进行微调的结果,而非添加了新层。
输入一个询问地球所围绕恒星名称的未完成英文句子时,两个模型都在第 29 层首次出现表示太阳的预测。这是将各层中间状态解读为下一个 token 候选的追踪结果,以下概率为仓库记录的数值。
表:相同输入下各层的预测概率
条件:NeuronDump 0.1.3、candle、CPU,两个模型均为 Q4_K_M,使用相同的 9 个 token 输入,询问地球所围绕恒星的名称
| 预测位置与对象 | Qwen3 8B | DeepSeek R1 8B |
|---|---|---|
| 第 30 层的中文太阳 token | 0.91 | 0.94 |
| 最后一层的英语定冠词 token | 0.45 | 0.35 |
中间层显现答案后,最后却选择了英语定冠词,仓库将这一过程解释为寻找事实与选择表达的两个阶段。开发者不必只看最终输出,还可观察候选在哪一层发生变化,并比较编辑该部分的效果。
3. 同时评估容量缩减与质量变化
仓库的 llama3.2:1b 测试方案使用示例语料库,将词表缩减至 570 个词项,文件大小从 1.23 GiB 降至 987 MiB,减少了 21.6%,GGUF 校验确认有 147 个张量和 16 层。缩减词表也会缩小输出可用的 token 范围。
移除层的效果通过一组固定评估文本组成的语料库进行比较。下方的 perplexity 表示模型预测这些文本的困难程度,越低越好。
表:移除层后的 perplexity
条件:candle、CPU、llama3.2:1b,使用由相同的 5 篇英文评估文本组成的语料库
| 移除的层 | 原模型 | 移除后 |
|---|---|---|
| 第 7 层 | 7.554 | 10.915 |
| 第 15 层 | 7.554 | 15.976 |
| 第 0 层 | 7.554 | 23257.776 |
此次评估中,移除第一层或最后一层比移除中间层更损害预测质量。容量缩减的收益需要以输出质量和探索时间为代价。测试方案中逐层排除并评估的搜索,对 5 个样本的 96 个位置执行了 85 次模型计算,在 CPU 上耗时约 4 分钟。
编辑流程不会改动原文件,而是先在内存中比较,再保存为新文件。开发者可以选出待删除的候选部分,用计划使用的句子评估质量,然后生成精简文件。
4. 根据运行支持范围选择实验对象
运行实验仅限于支持列表中模型系列的 CPU 处理,不支持运行通过选择专家进行计算的 MoE 模型或混合不同层机制的混合模型,也不支持通过从文件中裁去注意力头、神经元或专家来精简模型。
仓库将其标为早期版本,文档注明,新的 3 维数据流界面以及 token、编辑界面尚未在浏览器中进行运行验证。
NeuronDump 的价值不仅在于缩小模型,更在于让开发者结合结构与输出变化,决定精简哪些部分。