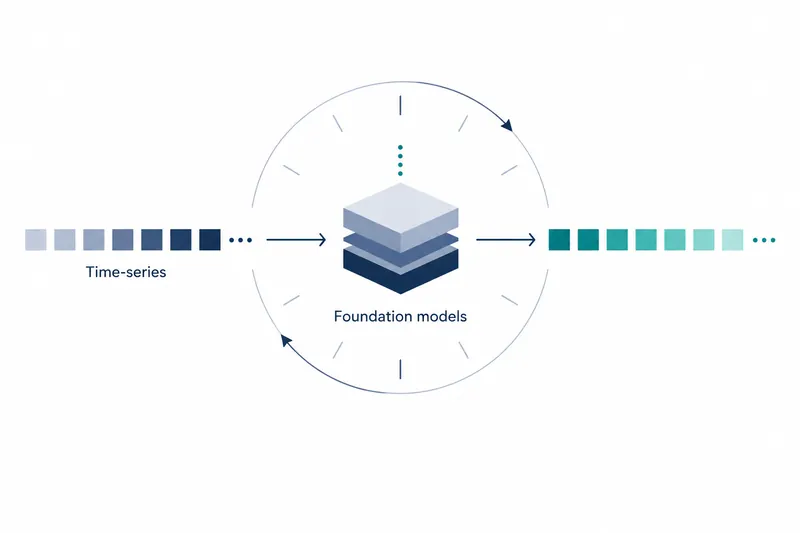
Mistral 发布了用于预测按时间积累的传感器数值或需求的预训练模型系列。开发设备监控或需求预测的团队无需针对每份数据从头训练,而可使用已训练的模型开始预测。它无需图形处理器,也能在服务器中央处理器上运行。
1. 可迁移到新数据的预测模型
Timestral 将从多种时间序列中预先学到的模式应用于新数据。这使其有别于拟合单条序列历史的传统模型,以及针对每个数据集从头训练的深度学习模型。对未见过的数据无需额外训练即可进行预测的方式称为零样本预测。
2. 公开评测的排名与比较范围
公司表示,在预训练零样本模型中,该系列在三项公开预测评测的五项指标上均排名第 1。这一成绩来自单次训练的结果,而非将多个模型的输出进行集成。
公司已向 GIFT-Eval 和 TIME 提交评测结果。
据其介绍,在这两项评测中,参数量为 2800 万的模型优于规模约为其 4 倍的 Chronos-2。
另一项评测是 fev-bench。包含完整结果的技术报告计划稍后发布,因此这些排名应被视为公司在发布时提供的评测结果。
据介绍,最大模型拥有 2 亿 900 万个参数,以此前最佳模型约三分之二的规模取得了更好的结果。公司表示,其参数量少于 TimesFM-3 和 Falcon-2.0,表现却领先。参数量衡量的是模型规模,并不等于实际运营成本。
3. 大小选择是准确性与延迟的权衡
模型有四种大小,参数量分别为 500 万、2800 万、1 亿 2300 万和 2 亿 900 万。公司称,它们的架构与训练方式相同,大模型的预测性能更高,小模型则更快、成本更低。
在标准服务器中央处理器上使用 8 个线程,以间隔 15 分钟的 3 周历史数据预测未来一天时,500 万参数模型的延迟为 10 毫秒,最大模型为 140 毫秒。公司未提供具体处理器型号。
在同一推理性能说明中,公司称 2800 万参数模型的速度为最大模型的 5 倍,1 亿 2300 万参数模型的延迟为最大模型的四分之三,得分差距在 0.2% 以内。公司未提供中间两款模型以毫秒计的实测值,也未说明该得分对应的具体指标。
选择小模型可以缩短推理时间、降低成本,但会牺牲部分准确性。因此,比起最大模型的排名,依据实际数据的预测误差和更新周期来选择大小更为合理。
4. 处理联动数值与未来条件
多变量预测是对泵的振动、温度、压力等相关序列进行联合预测的方式。它并非单独预测各个传感器,而是利用彼此的变化。
输出不是单一预测值,而是 21 个分位数。分位数以不同概率位置的数值表示预测分布,团队可据其范围设定考虑不确定性的告警阈值。
输入可包含仅在过去已知的辅助变量,以及生产计划等未来值预先已知的辅助变量。它也能直接接收星期、设备状态等类别值,因此无需将其转换为数字,赋予任意的顺序或大小。
在内部,模型将观测历史保留在上下文中用于预测,并区分辅助变量的作用,防止预测目标的未来值泄漏。它先用合成数据训练,再混合真实与合成数据进行后训练,最大输入上下文为 32,768 个时间点。
5. 应用于自有数据及运营注意事项
公司公开了可使用自有数据运行的 GitHub 仓库,但发布公告未提供运行代码或调用方法。
许可证标为 Modified MIT,但未提供详细条款。
通过 Mistral Forge,可选择使用自有数据进行额外训练、调整训练数据构成或扩展架构。
部署形式包括自有设施、虚拟私有云及与外部网络隔离的环境,完整训练流水线也可部署在客户硬件上。
公开评测的成绩不一定能在生产现场保持。若设备老化或需求变化导致数据特征改变,可能需要针对现场重新训练。无需额外训练即可起步虽有益处,但运营阶段仍需进行数据管理与适应工作。
Timestral 降低了开始预测的门槛,但部署决策仍需同时考虑模型大小和对现场数据的适应。