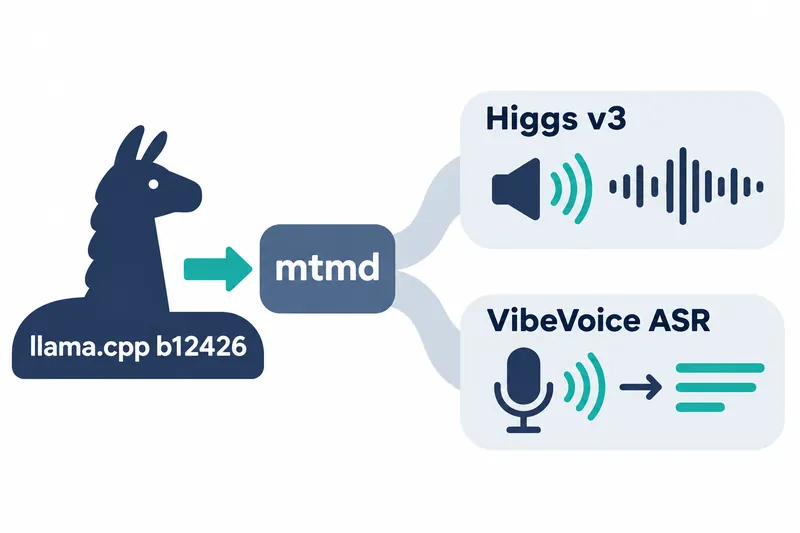
llama.cpp 新增了对两种语音识别模型的支持,为将语音转换为文本的开发者提供了更多选择。它们可用于上传文件或实时发送语音的路径,其中一种模型还会输出发言时间和说话人信息。
1. 从模型转换到服务器请求均获支持
2026年11月15日发布的 b12426 是正式发布前的测试版,即预发布版,为处理语音、图像等数据的 mtmd 加入了两种模型。此次变更涵盖从将模型转换为可运行格式,到服务器接收并处理语音的各个阶段。
支持的模型是 bosonai 的 Higgs Audio v3 和 microsoft 的 VibeVoice-ASR。前者用于语音转写,后者则提供包含谁在何时说了什么的转写。
评审者 ServeurpersoCom 表示,测试组合采用以 8 位格式 Q8_0 存储权重的文本模型,以及使用 16 位浮点格式表示小数的音频连接模型。测试使用了英语和法语片段,检查了语音转写 API、聊天补全 API 和实时转写会话。
2. Higgs Audio v3 将语音切分为 4 秒片段
Higgs Audio v3 将语音按 4 秒切分,在各片段中独立生成以数值表示声音特性的声学特征。评审者报告,在上述测试条件下,英语和法语片段的转写准确,34 秒的英语片段被分为 9 段后,结果也准确。
对于实时输入,系统会在一个片段填满后进行处理,输入结束时也会单独处理剩余的短片段。这种方式并非只将长录音作为一个整体接收,而是将传入的语音切分后连续处理。
3. VibeVoice-ASR 输出时间和说话人信息
VibeVoice-ASR 直接读取表示单通道声音随时间变化的 24 kHz 单通道波形,文件输入默认按 30 秒分段,同时读取前一片段的上下文。与独立处理各片段的前一种模型不同,它会结合此前听到的声音读取后续部分。
输出采用 JSON 格式,包含开始时间、结束时间、说话人 ID 和内容。这为希望在转写文本中定位发言片段或按说话人处理内容的开发者提供了用途。
提示词需要包含音频时长。接收音频文件的服务器从包含文件附加信息的元数据中获取时长,并将其纳入请求,也可将姓名或特定词语作为额外上下文传入。以下是将时长和附加信息放入请求语句的部分原始代码。
        } else if (is_vibevoice_asr_template(src)) {
            // without the audio length the model does not know where the audio ends and loops
            const char * keys = "transcribe it with these keys: Start time, End time, Speaker ID, Content";
            if (context.empty()) {
                asr_preset.user = string_format("\nThis is a %.2f seconds audio, please %s", audio_length, keys);
            } else {
                asr_preset.user = string_format("\nThis is a %.2f seconds audio, with extra info: %s\n\nPlease %s", audio_length, context.c_str(), keys);
                asr_preset.has_context = true;
            }
            asr_preset.media_first        = true;
评审者报告,36 秒片段在 30 秒边界处分段,表示发言时刻的时间戳和说话人信息均准确。在使用相同提示词进行对比的片段中,逐词结果与 transformers 实现一致,提示词中的附加信息也得到了体现。
4. 共用服务器路径,语音处理则适配各模型
希望应用这两种模型的开发者,可以利用模型转换支持和服务器的语音输入路径。评审中使用的路径包括 /v1/audio/transcriptions、/v1/chat/completions 以及实时转写会话。
在同一服务器内增加语音识别选项带来了便利,但负责各项功能软件处理步骤的处理层因模型而异。尤其是 VibeVoice-ASR 的实时处理,需要将前一片段的信息作为状态保存。
VibeVoice-ASR 的流式音量归一化会根据输入音量调整声音大小,其基准是截至当前已传入的语音,而非完整片段。两种模型的流式转写实现均不接受输入提示词。文件请求中传递额外上下文的功能可独立于这一流式限制使用。
b12426 的重点不仅是增加语音识别模型数量,还在于为现有的、同时处理多种数据类型的多模态服务器路径,增加了利用转写及时间、说话人信息的选项。