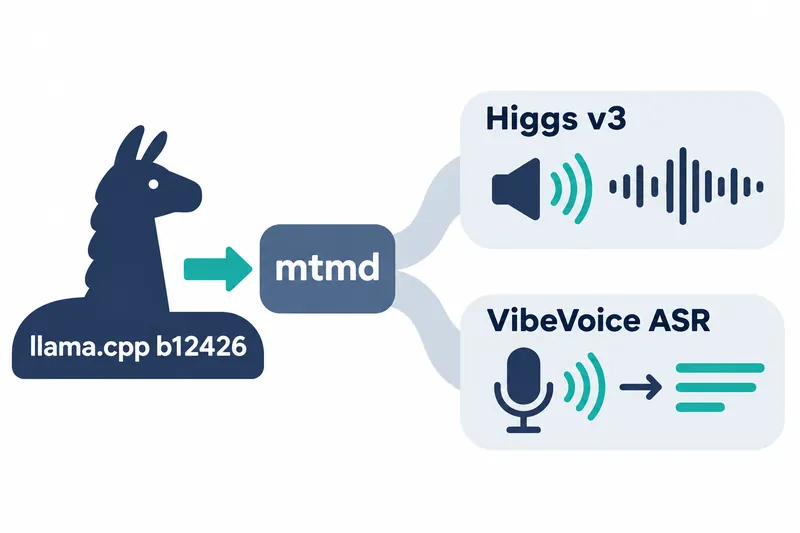
llama.cpp에 두 음성 인식 모델 지원이 추가돼, 음성을 텍스트로 바꾸는 개발자의 선택지가 늘었다. 파일을 올리거나 실시간으로 음성을 보내는 경로에서 사용할 수 있으며, 한 모델은 발언 시간과 화자 정보까지 출력한다.
1. 모델 변환부터 서버 요청까지 지원한다
2026년 11월 15일 공개된 b12426은 프리릴리스, 정식 공개 전 시험판으로, 음성·이미지 등을 처리하는 mtmd에 두 모델을 추가했다. 이번 변경은 모델을 실행 가능한 형식으로 변환하는 단계부터 서버가 음성을 받아 처리하는 단계까지 이어진다.
지원 대상은 bosonai의 Higgs Audio v3와 microsoft의 VibeVoice-ASR다. 전자는 음성 전사를, 후자는 누가 언제 무엇을 말했는지 담은 전사를 다루는 선택지다.
검토자 ServeurpersoCom은 텍스트 모델 가중치를 8비트로 저장하는 형식인 Q8_0과 소수를 16비트로 나타내는 16비트 부동소수점 형식의 오디오 연결 모델 조합으로 시험했다고 밝혔다. 영어와 프랑스어 클립을 사용했고, 음성 전사 API와 채팅 완성 API, 실시간 전사 세션을 확인했다.
2. Higgs Audio v3는 음성을 4초씩 나눈다
Higgs Audio v3는 음성을 4초 단위로 나눠 각 구간에서 독립적으로 소리의 특성을 수치로 나타낸 음향 특징을 만든다. 검토자는 앞서 밝힌 시험 조건에서 영어와 프랑스어 클립을 정확히 전사했고, 34초 영어 클립도 9개 구간으로 나뉜 상태에서 결과가 정확했다고 보고했다.
실시간 입력에서는 한 구간이 채워지면 처리하고, 입력을 마무리할 때 남은 짧은 구간도 별도로 처리한다. 긴 녹음을 한 덩어리로만 받는 대신, 들어온 음성을 잘라 이어서 다루는 방식이다.
3. VibeVoice-ASR는 시간과 화자 정보를 출력한다
VibeVoice-ASR는 24 kHz 한 채널 소리의 시간별 변화를 나타내는 단일 채널 파형을 직접 읽고, 파일 입력은 기본 30초 구간으로 나누되 앞 구간의 문맥도 함께 읽는다. 구간을 독립적으로 처리하는 앞 모델과 달리, 앞서 들은 소리와 연결해 다음 부분을 읽는 방식이다.
출력은 시작·종료 시간, 화자 ID, 내용이 포함된 JSON 형식이다. 전사문에서 발언 구간을 찾거나 화자별로 내용을 다루려는 개발자에게 활용 지점이 생긴다.
프롬프트에는 오디오 길이가 필요하다. 음성 파일을 받는 서버는 파일에 관한 부가 정보를 담은 메타데이터에서 길이를 얻어 요청에 포함하며, 이름이나 특정 단어를 추가 문맥으로 전달할 수도 있다. 다음은 길이와 추가 정보를 요청 문장에 넣는 원문 코드 일부다.
        } else if (is_vibevoice_asr_template(src)) {
            // without the audio length the model does not know where the audio ends and loops
            const char * keys = "transcribe it with these keys: Start time, End time, Speaker ID, Content";
            if (context.empty()) {
                asr_preset.user = string_format("\nThis is a %.2f seconds audio, please %s", audio_length, keys);
            } else {
                asr_preset.user = string_format("\nThis is a %.2f seconds audio, with extra info: %s\n\nPlease %s", audio_length, context.c_str(), keys);
                asr_preset.has_context = true;
            }
            asr_preset.media_first        = true;
검토자는 36초 클립이 30초 경계에서 나뉘고 발언 시점을 나타내는 타임스탬프와 화자 정보가 정확했다고 보고했다. 같은 프롬프트로 비교한 클립에서는 transformers 구현과 단어별 결과가 같았으며, 프롬프트에 넣은 추가 정보도 반영됐다.
4. 같은 서버 경로를 쓰되 음성 처리는 모델에 맞춘다
두 모델을 적용하려는 개발자는 모델 변환 지원과 서버의 음성 입력 경로를 활용할 수 있다. 검토에서 사용한 경로는 /v1/audio/transcriptions와 /v1/chat/completions, 실시간 전사 세션이다.
같은 서버 안에서 음성 인식 선택지를 늘리는 이점이 있는 대신, 기능별 소프트웨어 처리 단계를 맡는 처리 계층은 모델별로 달라진다. 특히 VibeVoice-ASR의 실시간 처리는 앞 구간의 정보를 상태로 보관하는 작업을 맡는다.
입력 음량에 맞춰 소리 크기를 조절하는 VibeVoice-ASR의 스트리밍 음량 정규화 기준은 전체 클립이 아니라 현재까지 들어온 음성이며, 두 모델의 스트리밍 전사 구현은 입력 프롬프트를 받지 않는다. 파일 요청에서 추가 문맥을 전달하는 기능은 이 스트리밍 제약과 별개로 사용할 수 있다.
b12426의 핵심은 음성 인식 모델 수를 늘리는 데서 나아가, 전사와 시간·화자 정보를 기존 여러 유형의 데이터를 함께 다루는 멀티모달 서버 경로에서 활용할 선택지를 더한 데 있다.