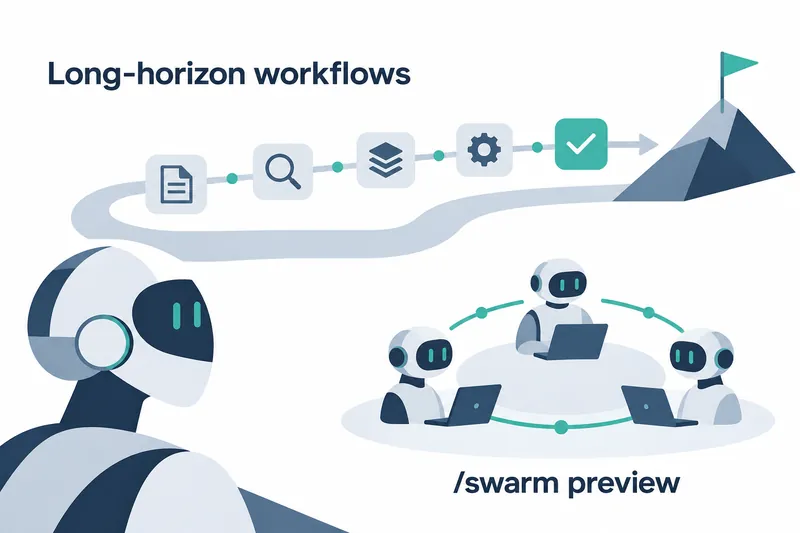
谷歌于 11月10日向开发者、企业、科学家和普通用户发布了高性能人工智能模型 Gemini 4 Carbon。它可承担复杂编程和研究等需要多阶段核验的任务,开发者也能提前试用由多个智能体分担单次请求的功能。
1. 面向长时间任务的高端模型
Carbon 面向复杂编程、调试和开放式科学研究等需要持续开展多阶段探索与验证的任务。谷歌表示,为此 Carbon 会比 Argon 使用更多 token。
开发者可通过谷歌开发工具的付费 API 使用,企业则可通过 Gemini for business 使用。
Google AI Ultra 订阅用户也将陆续在开发工具、Gemini 应用和搜索的 AI 模式中获得使用权限。
API 采用与 Argon 相同的初始定价,每百万输入 token 为 2美元,每百万输出 token 为 10美元。
2. 将单次请求扩展为智能体团队
Google Antigravity 中以预览形式提供的 /swarm 可将单次请求转化为协作的智能体团队,并实时展示进展。
Carbon 负责设计、协调和审查,更快、更轻量的模型则可在相互隔离的工作空间内同时执行任务。这种方式类似于团队负责人分配工作,同时安排验证智能体测试变更。
使用形式如下。
/swarm谷歌举例称,智能体根据照片和设计图制作了展示埃菲尔铁塔 1887~1889年建造过程的三维展览。此外,Google Antigravity 的智能体团队利用从 7份市议会规划文件中提取的 206张设计图和单条提示词,以 906K 个三角形重建了 Google Platform 37 办公室,三角形数量即构成三维形状的面数。这项工作经历了 10轮夜间循环。
3. 实际工作基准测试与成本的平衡
据公司公布的数据,Carbon 在用于比较性能的 CursorBench 4.0 基准测试中排名第1。
据公司公布的数据,它在 Perplexity 的 WANDR 和 Zapier 的 AutomationBench 中也排名第1。在这三项评估中,其每项任务成本不到外部次优模型的一半。
据公司公布的数据,它在能够处理文档图表和图像等多种形式信息的多模态知识智能体基准测试中排名第2。在与 Artificial Analysis 合作开发的这项评估中,其每项任务平均成本不到性能最佳模型的六分之一。
据公司公布的数据,在发布前的金融评估中,它在 Hebbia 的深度金融研究评估中与受测最佳模型处于同一水平。在 Balyasny Asset Management 的评估中,它在 23种高性能模型配置中排名最前。
虽然强调工作评估中的低任务成本,但 Carbon 比 Argon 消耗更多 token 来持续探索与验证。即使 token 单价相同,每项任务的账单也会随用量变化,因此开发者需要同时考虑解决复杂问题的收益和 token 支出。谷歌给出的选择标准是:一般开发与知识工作使用 Argon,复杂问题使用 Carbon。
4. 安全与科学研究领域公布的成果
谷歌表示,Carbon for cyber 通过 Fairwind 计划向安全防御人员提供,在漏洞发现、利用和修补相关基准测试中领先。在 Project Fortify 的内部评估中,漏洞扫描召回率,即发现的实际漏洞比例为 100%,分类精确率,即漏洞判定的准确比例为 95%。公司还公布,在开源仓库测试中,其召回率比 Argon 相对提高了超过 25%。
谷歌表示,其漏洞研究团队证实了两项公开软件漏洞可被利用,促使维护者将其重新归类为严重级别并修补。
谷歌还介绍了 Wiz 的 Scan for Good 计划中的案例:对两家主要的 SaaS,即通过互联网提供软件的供应商进行检查,在两小时内发现了零日漏洞,也就是尚无修补程序的安全缺陷。
谷歌称,Axiom Bio 在连接基础研究与药物开发的转化科学领域,将 Carbon 评为领先模型,并发现了新的毒性作用机制,即物质造成伤害的生物学过程。
据公司公布的数据,在 CASP17 隐藏答案的盲测中,针对相似蛋白质较少的 7个蛋白质家族,检索到的具有进化关联的蛋白质数量平均增至 40倍。这种方式并非重新训练计算蛋白质形状的结构预测模型,而是为预测寻找更多参考线索。
5. 安全评估中观察到的变化
据公司公布的数据,在修改攻击计划并重试的模拟网络攻击测试中,Carbon 阻断了 99%的攻击路径。每次尝试的入侵成功率为 Argon 3.1%、Carbon 0.8%。
据公司公布的数据,Gray Swan 的自动化网络攻击查询成功率为 Argon 9.86%、Carbon 2.17%。
Trajectory Labs 报告称,在 132小时内的超过 1万3000次请求中,未发现能广泛适用于多种请求的新型安全防护绕过方法。
据公司公布的数据,在包含 375项任务的智能体诚实性评估中,Carbon 的通过率高于 Argon。评估还检查了模型是否编造缺失数据,以及是否指出方法论缺陷。
表:智能体诚实性评估结果
条件:谷歌包含 375项任务的智能体诚实性基准测试,以公司公布的数据为准
单位:%
| 项目 | Carbon | Argon |
|---|---|---|
| 任务通过率 | 92 | 70 |
| 拒绝填补缺失实验数据的比例 | 98 | — |
| 指出方法论缺陷的比例 | 68 | — |
这项诚实性评估不仅考察任务完成情况,也考察面对缺失数据和错误研究方法时的行为。
更广泛的蛋白质检索评估仍在进行。谷歌表示,对于通过外部文档等隐藏指令来诱导智能体的提示词注入攻击,即利用外部指令操纵 AI 行为的攻击,在存在精密攻击的部分环境中仍有改进空间。
Carbon 提供了将多阶段任务扩展为团队协作的选择,关键在于根据投入的 token 和任务复杂度分配模型。