Cloudflare 于10月12日发布技术文章,说明 Logpush Transformers 的工作方式。Logpush 用于把 Cloudflare 日志导出到 SIEM、分析平台和对象存储。
Transformers 已在 Birthday Week 期间正式发布(GA)。10月12日的文章是对现有功能的技术说明,而非新发布。
对于正在决定在哪里过滤日志或删除敏感信息的团队,关键在于变换失败不会变成绕过变换。
附加在 NDJSON 作业上的单条 SQL 查询
Transformer 会在 Logpush 投递批次之前,对记录应用一条 SQL 查询。WHERE 选择保留的记录,SELECT 的输出成为投递的记录。
附加对象必须是使用同一数据集的 NDJSON 输出作业。FROM 中的表名与作业数据集不一致时,附加会失败。
这是范围受限的记录变换,而不是通用 SQL 数据仓库。不支持联接、子查询、聚合、窗口函数和 ORDER BY。
在 Logpush 投递进程内执行的变换
据技术文章介绍,变换不经过单独的远程调用,而是在 Logpush 投递服务内部用 Rust 查询引擎 Apache DataFusion 执行。早期原型调用 Workers,但会在投递路径中引入网络调用,因此改用此设计。
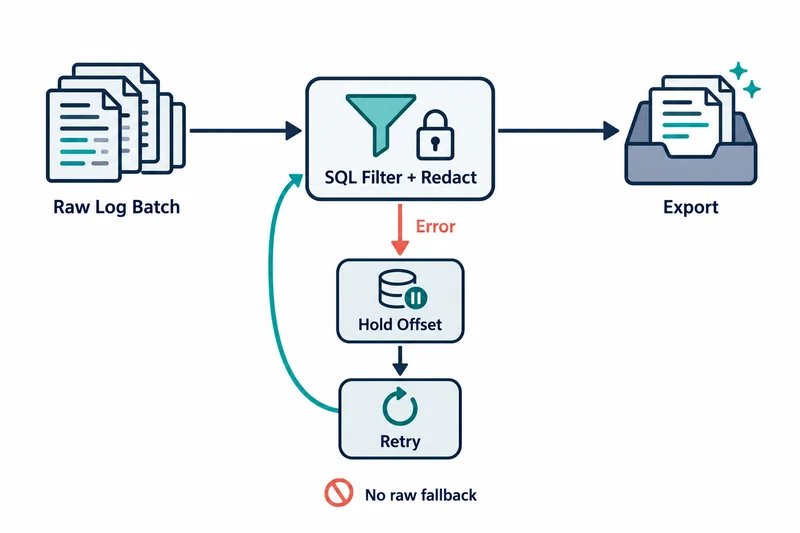
变换无法执行时,作业的投递偏移量不会推进,未变换的批次也不会发送。Cloudflare 将此称为失败即阻断(fail closed)设计。
Logpush 会逐步拉长重试间隔,并在作业上报告错误。长期处于失败状态的作业会被自动停用。
注意事项:重试不是保留承诺
文档写明,如果失败持续,受影响批次中的记录最终会被丢弃且无法恢复。保持偏移量并重试,并不保证无限期保留或最终投递。
最近一次错误显示在作业的 last_error 字段中。文档列出的常见原因是输出超出大小限制和 Cloudflare 内部错误。
取舍很明确。阻止未变换日志外流的同时,事件调查所需的数据流可能中断。
从过滤器迁移到 Transformer 的条件
一个 Logpush 作业只能设置过滤器或 Transformer 之一。在仪表板中,Transformer Studio 会把现有过滤器转换为等价的 SQL 条件,只有把它放进 WHERE 才能保持过滤行为。
API 不会执行这种转换。需要自行把过滤器改写为 SQL 条件放入 WHERE,然后在同一个作业更新请求中清空 filter 并设置 transformer_id。
{
	"filter": "",
	"transformer_id": 42
}
不清空 filter 只设置 transformer_id,API 会返回 400。如果不迁移现有的选择规则就只接入新 SQL,外发的事件会发生变化。
预览基于每个数据集的一条示例记录运行。预览成功并不能证明所有生产情况都已覆盖。
先于 SQL 语法的输出条件
引入时,从期望的输出条件出发比从最短的查询出发更合适。先确定哪些字段可以外发、哪些字段留作调查、哪些记录要有意排除。
用包含缺失值或特殊内容的代表性记录测试,再确认实际投递结果。删除或重命名一个显眼的标识符,并不意味着其余字段中的敏感信息也已消失。
这部分是 SQL 语法检查无法完成的策略与数据审查。
分别监控变换成功与记录到达
监控需要分别回答两个问题:变换是否成功,预期的记录是否到达。
发送量下降可能是过滤的效果,也可能是排除条件过宽或作业停滞。保存已批准的查询和预期输出示例,就能用同一基准判断变更。
回退发送原始日志不是恢复计划。失败的变换是需要诊断和修复的对象。
失败即阻断只有与投递监控和数据缺失应对计划一起使用时才有价值,且不能替代其中任何一项。